第9章 数据挖掘
学习目标
说明数据挖掘与知识发现的关系,以及数据挖掘相对于传统数据分析的特点。
识别描述型任务和预测型任务,列举分类、预测、聚类、关联分析和异常点分析的典型应用。
计算信息熵、条件熵、信息增益、信息增益比和基尼指数,并解释它们在决策树特征选择中的作用。
比较 ID3、C4.5 和 CART 决策树算法在分裂准则、属性处理、剪枝和任务类型上的差异。
计算支持度、置信度和提升度,并说明 Apriori 发现频繁项集的基本思想。
比较 k-means、层次聚类和 DBSCAN 的适用条件、优缺点和主要参数。
引言
随着数据库、数据仓库和各类信息系统的广泛应用,组织积累的数据规模持续增长。仅依靠查询、报表和联机分析,往往只能回答已知的问题;面对海量数据中隐含的规律和趋势,还需要更系统的自动分析方法。数据挖掘研究如何从大规模、不完全、含噪声的数据中发现隐含的、事先未知的、具有潜在价值的信息和知识,它强调在大规模、高维、含噪声的数据中自动搜索模式,是知识发现流程中的核心环节。
本章以数据挖掘的基本概念为起点,依次讨论数据预处理、信息熵与特征选择、决策树分类、关联规则挖掘、聚类分析和异常点分析,最后介绍数据挖掘的应用与社会影响。内容侧重基础模型、算法思想和适用条件,覆盖分类、预测、聚类、关联分析等描述型与预测型任务的典型方法,有助于读者建立从原始数据到决策知识的完整分析视角,为后续学习更深入的机器学习方法奠定基础。
9.1 数据挖掘概论
9.1.1 数据挖掘与知识发现
数据挖掘是从大量数据中发现隐含规律和知识的过程。通常所说的知识发现(Knowledge Discovery from Data, KDD)包含数据选择、预处理、变换、数据挖掘以及结果解释与评价等阶段;数据挖掘处于其中的核心环节。数据挖掘所发现的知识应当具有隐含性、事先未知性、潜在有用性和可理解性,这与数据库查询、报表统计或人工经验归纳存在区别。
传统数据分析往往依据明确的假设和统计模型,数据挖掘则强调在大规模、高维、含噪声的数据中自动搜索模式。例如,银行可以从历史交易数据中学习“高风险贷款申请”的特征,零售企业可以从购物记录中发现商品之间的关联,电信运营商可以从通话行为中识别异常账户。这些任务通常难以仅通过人工观察完成,需要借助算法从数据中建立模型。
9.1.2 数据挖掘的发展背景
数据挖掘的发展建立在数据库技术、统计学、机器学习和可视化技术的基础上。数据库系统解决了数据的集中存储、共享和事务处理,数据仓库进一步提供了面向分析主题的历史数据集合。随着计算能力提高和数据规模扩大,统计建模和机器学习方法能够应用于更大规模的现实数据,数据挖掘逐渐成为从数据资源中获取决策知识的重要途径。
数据挖掘的典型工作流程可用图9-1 表示。
kdd_process
business
业务问题与分析目标
select
数据选择
business->select
clean
数据清洗与预处理
select->clean
transform
数据变换
clean->transform
mining
数据挖掘
分类、聚类、关联等
mining->transform
evaluate
模式解释与评价
evaluate->clean
evaluate->mining
decision
决策应用
decision->evaluate
图9-1 知识发现与数据挖掘的基本过程
9.1.3 数据挖掘系统的分类
数据挖掘系统可以按照数据类型、知识类型、应用领域和技术路线进行分类。按照数据类型,可分为关系数据库、数据仓库、事务数据、文本、Web 和流数据等挖掘系统;按照挖掘任务,可分为特征描述、关联规则、分类、预测、聚类、异常点分析和演化分析等系统;按照应用领域,可分为金融、电信、生物信息、电子商务和工业互联网等专用系统;按照技术路线,还可区分基于数据库、基于统计学、基于机器学习和基于可视化的实现方式。
表9-1 数据挖掘任务类型
任务类型
核心问题
典型方法或应用
特征描述
总结、比较数据对象的总体特征
数据汇总、属性相关性分析
关联规则
发现属性或项集之间频繁出现的联系
购物篮分析、商品推荐
分类
根据已知类别样本建立分类模型
信用审批、垃圾邮件识别
预测
估计连续型目标变量的值
销量预测、价格预测
聚类
在无类别标签的条件下发现自然分组
客户细分、文档聚类
异常点分析
识别显著偏离大多数对象的样本
欺诈检测、故障诊断
演化分析
描述对象或模式随时间变化的规律
时间序列趋势、事件演化
9.2 数据预处理
9.2.1 数据预处理的必要性
现实数据通常存在缺失值、噪声、不一致表示和尺度差异。缺失值可能来自录入遗漏、设备故障或数据合并,噪声可能来自测量误差或异常记录,不一致则表现为不同系统对同一属性的命名、编码或度量单位不同。若不经处理直接挖掘,模型可能学习到错误模式,结果也难以解释。数据预处理的目标是在保留主要信息的前提下,提高数据质量和算法效率。
9.2.2 数据清洗与集成
数据清洗 处理缺失值、噪声和不一致。缺失值可以采用忽略记录、全局常量填充、属性均值或中位数填充、回归预测以及基于相似样本的估计等方法。噪声数据可以通过分箱平滑、回归拟合或聚类检测进行处理。数据集成 将来自多个数据源的数据合并到统一视图,其核心问题包括模式匹配、实体识别和冗余消除。例如,数据库 A 中的 cust_id 与数据库 B 中的 customer_no 可能指向同一客户,需要通过属性名称、取值和语义共同判断。
9.2.3 数据变换
数据变换改变数据的表示形式,使不同属性在数值范围、分布形态和粒度层次上更适合后续算法。
1. 规范化
规范化将数据按比例缩放到特定范围,避免取值范围较大的属性在距离计算中主导结果。常用方法包括最小-最大规范化、z-score 标准化。
(1) 最小-最大规范化(Min-Max Normalization)
将原始值线性映射到指定区间 [ n e w _ m i n , n e w _ m a x ] [new\_min, new\_max] [ n e w _ min , n e w _ ma x ] [ 0 , 1 ] [0,1] [ 0 , 1 ] v ′ = v − min A max A − min A × ( n e w _ m a x − n e w _ m i n ) + n e w _ m i n (9-1) v' = \frac{v - \min_A}{\max_A - \min_A} \times (new\_max - new\_min) + new\_min \tag{9-1} v ′ = max A − min A v − min A × ( n e w _ ma x − n e w _ min ) + n e w _ min ( 9-1 ) v v v A A A min A \min_A min A max A \max_A max A
适用性 :适用于数据的最大值和最小值已知且稳定的场景。缺点是对离群值敏感——若新数据超出原始范围,需要重新计算。
(2) z-score 标准化(零均值规范化)
将数据变换为均值为 0、标准差为 1 的标准正态分布:
v ′ = v − A ˉ σ A (9-2) v' = \frac{v - \bar{A}}{\sigma_A} \tag{9-2} v ′ = σ A v − A ˉ ( 9-2 ) A ˉ \bar{A} A ˉ A A A σ A \sigma_A σ A
适用性 :当数据的最小值和最大值未知,或需要降低离群值影响时较为适用,常用于基于距离或梯度的算法。
2. 常用数据变换
聚合将日销量汇总为月销量或年销量,从而降低数据粒度。
泛化利用概念分层将具体值替换为高层概念,例如将街道地址转换为城市或省份。
对数变换 v ′ = log ( v ) v'=\log(v) v ′ = log ( v )
离散化将连续属性转换为区间或类别,例如把年龄划分为“青年”“中年”“老年”。
3. 数据归约
数据归约目的是缩小数据集规模或降低数据维度,同时尽可能保持原始数据的分析价值。
特征选择(Feature Selection) :删除与挖掘任务无关或冗余的属性。常用方法包括前向选择、后向消去以及基于相关性分析的过滤法。主成分分析(PCA, Principal Component Analysis) :通过正交变换将原始的 n n n k k k k ≪ n k \ll n k ≪ n k k k
对数据进行 z-score 标准化
对中心化后的数据矩阵 X X X Σ = 1 n − 1 X T X \Sigma = \frac{1}{n-1}X^TX Σ = n − 1 1 X T X
求解协方差矩阵的特征值 λ 1 ≥ λ 2 ≥ ⋯ ≥ λ n \lambda_1 \geq \lambda_2 \geq \cdots \geq \lambda_n λ 1 ≥ λ 2 ≥ ⋯ ≥ λ n
选取前 k k k ∑ i = 1 k λ i ∑ i = 1 n λ i ≥ 85 % \frac{\sum_{i=1}^k \lambda_i}{\sum_{i=1}^n \lambda_i} \geq 85\% ∑ i = 1 n λ i ∑ i = 1 k λ i ≥ 85%
适用性 :PCA 适用于特征维度较高且特征间存在线性相关性的场景。
9.3 信息熵与特征选择
9.3.1 信息熵
1948年,克劳德·香农(Claude Shannon)提出了**信息熵(Entropy)**的概念,为度量信息的不确定性奠定了数学基础。
对于一个离散随机变量 Y Y Y m m m { y 1 , y 2 , … , y m } \{y_1, y_2, \ldots, y_m\} { y 1 , y 2 , … , y m } p i = P ( Y = y i ) p_i = P(Y = y_i) p i = P ( Y = y i ) Y Y Y 信息熵 定义为:
H ( Y ) = − ∑ i = 1 m p i log 2 p i (9-3) H(Y) = -\sum_{i=1}^{m} p_i \log_2 p_i \tag{9-3} H ( Y ) = − i = 1 ∑ m p i log 2 p i ( 9-3 )
其中约定 0 log 2 0 = 0 0 \log_2 0 = 0 0 log 2 0 = 0 比特(bit) 。
信息熵具有以下基本性质:
当所有类别等概率出现时(p i = 1 / m p_i = 1/m p i = 1/ m H m a x = log 2 m H_{max} = \log_2 m H ma x = log 2 m
当某一类概率为 1 时,熵为 0,表示完全确定。
对于二分类问题(m = 2 m=2 m = 2 H = − p log 2 p − ( 1 − p ) log 2 ( 1 − p ) H = -p \log_2 p - (1-p) \log_2 (1-p) H = − p log 2 p − ( 1 − p ) log 2 ( 1 − p ) p = 0.5 p=0.5 p = 0.5
9.3.2 条件熵与信息增益
在分类问题中,特征选择需要衡量引入某个特征后类别不确定性的减少程度。
条件熵(Conditional Entropy)
已知特征 A A A D D D Y Y Y H ( Y ∣ A ) = ∑ j = 1 v ∣ D j ∣ ∣ D ∣ H ( Y ∣ A = a j ) = − ∑ j = 1 v ∣ D j ∣ ∣ D ∣ ∑ i = 1 m p i j log 2 p i j (9-4) H(Y|A) = \sum_{j=1}^{v} \frac{|D_j|}{|D|} H(Y|A=a_j) = -\sum_{j=1}^{v} \frac{|D_j|}{|D|} \sum_{i=1}^{m} p_{ij} \log_2 p_{ij} \tag{9-4} H ( Y ∣ A ) = j = 1 ∑ v ∣ D ∣ ∣ D j ∣ H ( Y ∣ A = a j ) = − j = 1 ∑ v ∣ D ∣ ∣ D j ∣ i = 1 ∑ m p ij log 2 p ij ( 9-4 ) A A A v v v { a 1 , a 2 , … , a v } \{a_1, a_2, \ldots, a_v\} { a 1 , a 2 , … , a v } D j D_j D j D D D A = a j A = a_j A = a j p i j = P ( Y = y i ∣ A = a j ) p_{ij} = P(Y=y_i | A=a_j) p ij = P ( Y = y i ∣ A = a j ) D j D_j D j y i y_i y i
信息增益(Information Gain)
信息增益定义为原始熵与条件熵之差,表示得知特征 A A A Y Y Y G a i n ( D , A ) = H ( Y ) − H ( Y ∣ A ) (9-5) Gain(D, A) = H(Y) - H(Y|A) \tag{9-5} G ain ( D , A ) = H ( Y ) − H ( Y ∣ A ) ( 9-5 )
ID3 决策树算法优先选择信息增益最大的特征作为分裂特征,因为信息增益越大,按该特征划分后类别不确定性下降越明显。
计算示例 :设数据集 D D D
表9-2 信息增益计算示例数据
T1
T2
T3
类别 S
A
70
1
类1
A
90
1
类2
A
85
0
类2
A
95
0
类2
A
70
0
类1
B
90
1
类1
B
78
0
类1
B
65
1
类1
B
75
0
类1
C
80
1
类2
C
70
1
类2
C
80
0
类1
C
80
0
类1
C
96
0
类1
(1) 类别 S 的熵
14 个样本中,类1 有 9 个,类2 有 5 个,则:
H ( S ) = − 9 14 log 2 9 14 − 5 14 log 2 5 14 ≈ 0.410 + 0.530 ≈ 0.940 bit H(S) = -\frac{9}{14}\log_2\frac{9}{14} - \frac{5}{14}\log_2\frac{5}{14} \approx 0.410 + 0.530 \approx 0.940 \text{ bit} H ( S ) = − 14 9 log 2 14 9 − 14 5 log 2 14 5 ≈ 0.410 + 0.530 ≈ 0.940 bit
(2) 类别 S 关于 T1 的条件熵
按 T1 的取值将 D D D
表9-3 T1取值子集的熵计算
T1 取值
样本数
类1
类2
子集熵 H ( S ∣ T 1 = a j ) H(S\mid T1=a_j) H ( S ∣ T 1 = a j )
A
5
2
3
− 2 5 log 2 2 5 − 3 5 log 2 3 5 ≈ 0.971 -\frac{2}{5}\log_2\frac{2}{5}-\frac{3}{5}\log_2\frac{3}{5}\approx 0.971 − 5 2 log 2 5 2 − 5 3 log 2 5 3 ≈ 0.971
B
4
4
0
0 0 0
C
5
3
2
− 3 5 log 2 3 5 − 2 5 log 2 2 5 ≈ 0.971 -\frac{3}{5}\log_2\frac{3}{5}-\frac{2}{5}\log_2\frac{2}{5}\approx 0.971 − 5 3 log 2 5 3 − 5 2 log 2 5 2 ≈ 0.971
H ( S ∣ T 1 ) = 5 14 × 0.971 + 4 14 × 0 + 5 14 × 0.971 ≈ 0.694 bit H(S|T1) = \frac{5}{14}\times 0.971 + \frac{4}{14}\times 0 + \frac{5}{14}\times 0.971 \approx 0.694 \text{ bit} H ( S ∣ T 1 ) = 14 5 × 0.971 + 14 4 × 0 + 14 5 × 0.971 ≈ 0.694 bit (3) T1 带来的信息增益
G a i n ( D , T 1 ) = H ( S ) − H ( S ∣ T 1 ) ≈ 0.940 − 0.694 = 0.246 bit Gain(D, T1) = H(S) - H(S|T1) \approx 0.940 - 0.694 = 0.246 \text{ bit} G ain ( D , T 1 ) = H ( S ) − H ( S ∣ T 1 ) ≈ 0.940 − 0.694 = 0.246 bit 计算结果表明,已知 T1 的取值后,类别 S 的不确定性约减少 0.246 bit。其中 T1=B 的子集全部属于类1,纯度最高,对信息增益的贡献最大。若再分别计算 T2、T3 的信息增益,则可选取增益最大的属性作为决策树的分裂属性。
9.3.3 信息增益比
信息增益倾向于选择取值较多的特征。以“身份证号”为例,若该属性每个取值只对应一个样本,按它划分后每个子集的类别纯度都很高,信息增益接近最大,但这样的划分并不具有对新样本的泛化能力。
为了校正这一偏向,**信息增益比(Information Gain Ratio)**引入了一个惩罚项——分裂信息值(Split Information) ,对信息增益进行规范化:
S p l i t I n f o A ( D ) = − ∑ j = 1 v ∣ D j ∣ ∣ D ∣ log 2 ∣ D j ∣ ∣ D ∣ (9-6) SplitInfo_A(D) = -\sum_{j=1}^{v} \frac{|D_j|}{|D|} \log_2 \frac{|D_j|}{|D|} \tag{9-6} S pl i t I n f o A ( D ) = − j = 1 ∑ v ∣ D ∣ ∣ D j ∣ log 2 ∣ D ∣ ∣ D j ∣ ( 9-6 ) G a i n R a t i o ( D , A ) = G a i n ( D , A ) S p l i t I n f o A ( D ) (9-7) GainRatio(D, A) = \frac{Gain(D, A)}{SplitInfo_A(D)} \tag{9-7} G ain R a t i o ( D , A ) = S pl i t I n f o A ( D ) G ain ( D , A ) ( 9-7 ) 分裂信息值 S p l i t I n f o A ( D ) SplitInfo_A(D) S pl i t I n f o A ( D ) A A A A A A S p l i t I n f o A ( D ) SplitInfo_A(D) S pl i t I n f o A ( D ) C4.5 算法 改进 ID3 算法的核心所在。
计算示例 :仍以表9-2 的数据为例,计算属性 T1 的信息增益比。
由 9.3.2 节已知 G a i n ( D , T 1 ) ≈ 0.246 Gain(D, T1) \approx 0.246 G ain ( D , T 1 ) ≈ 0.246 S p l i t I n f o T 1 ( D ) = − 5 14 log 2 5 14 − 4 14 log 2 4 14 − 5 14 log 2 5 14 ≈ 0.530 + 0.516 + 0.530 ≈ 1.577 bit SplitInfo_{T1}(D) = -\frac{5}{14}\log_2\frac{5}{14} - \frac{4}{14}\log_2\frac{4}{14} - \frac{5}{14}\log_2\frac{5}{14} \approx 0.530 + 0.516 + 0.530 \approx 1.577 \text{ bit} S pl i t I n f o T 1 ( D ) = − 14 5 log 2 14 5 − 14 4 log 2 14 4 − 14 5 log 2 14 5 ≈ 0.530 + 0.516 + 0.530 ≈ 1.577 bit
信息增益比为:
G a i n R a t i o ( D , T 1 ) = G a i n ( D , T 1 ) S p l i t I n f o T 1 ( D ) ≈ 0.246 1.577 ≈ 0.156 GainRatio(D, T1) = \frac{Gain(D, T1)}{SplitInfo_{T1}(D)} \approx \frac{0.246}{1.577} \approx 0.156 G ain R a t i o ( D , T 1 ) = S pl i t I n f o T 1 ( D ) G ain ( D , T 1 ) ≈ 1.577 0.246 ≈ 0.156
与信息增益相比,信息增益比除以了反映取值个数与分布均匀程度的分裂信息值,因此对取值较多的属性施加了惩罚。
信息增益比虽然纠正了对多取值特征的偏好,但可能反过来偏向于取值较少的特征。在实际应用中(如 C4.5 算法),通常先从候选特征中选出信息增益高于平均水平的特征,再从中选取信息增益比最高者。
9.4 决策树分类算法
🎬 教学动画:信息熵与决策树(2:06) 9.4.1 决策树基本概念
**决策树(Decision Tree)**是一种类似于流程图的树形结构,它模拟了人类决策的过程。树的每个内部节点代表对某个属性的测试,每个分支代表测试的结果,而叶节点则承载着最终的类别标签。从根节点到叶节点的每一条路径都代表了一条分类规则,具有极高的可解释性。
9.4.2 主要决策树算法
决策树学习通常采用自顶向下的递归划分策略,先选择一个区分能力最强的属性作为根节点,再对划分后的样本子集递归生成子树。不同算法的主要差异体现在分裂准则、属性处理和剪枝方式。
1. ID3 算法
ID3 由 J. Ross Quinlan 于 20 世纪 80 年代提出,采用信息增益作为分裂准则。
算法步骤 :
计算数据集 D D D H ( Y ) H(Y) H ( Y )
对每个候选特征 A A A G a i n ( D , A ) = H ( Y ) − H ( Y ∣ A ) Gain(D, A) = H(Y) - H(Y|A) G ain ( D , A ) = H ( Y ) − H ( Y ∣ A )
选择信息增益最大的特征 A ∗ = arg max A G a i n ( D , A ) A^* = \arg\max_A Gain(D, A) A ∗ = arg max A G ain ( D , A )
按 A ∗ A^* A ∗ D D D
当子集中所有样本属于同一类别,或无剩余特征可分裂时,生成叶节点
局限性 :只能处理离散属性;倾向于选择取值多的特征;不支持剪枝,容易过拟合。
2. C4.5 算法
作为 ID3 的改进版本,它做出了以下关键改进:
分裂准则 :采用信息增益比 G a i n R a t i o ( D , A ) GainRatio(D, A) G ain R a t i o ( D , A ) 连续属性处理 :对连续属性 A A A n n n { a 1 , a 2 , … , a n } \{a_1, a_2, \ldots, a_n\} { a 1 , a 2 , … , a n } n − 1 n-1 n − 1 t i = a i + a i + 1 2 t_i = \frac{a_i + a_{i+1}}{2} t i = 2 a i + a i + 1 t ∗ t^* t ∗ A ≤ t ∗ A \leq t^* A ≤ t ∗ A > t ∗ A > t^* A > t ∗ 缺失值处理 :通过加权的方式处理含缺失值的样本,未缺失样本以权重参与信息增益的计算,缺失值样本按比例分配到各子节点。
计算示例(连续属性处理) :表9-2 中的 T2 为连续属性,以下演示 C4.5 如何确定 T2 的最优分割点。
(1) 排序并统计各取值的类别分布
T2 共有 9 个不同取值,按升序排列后,各取值对应的类别数量如下:
表9-4 T2取值的类别分布
T2 取值
65
70
75
78
80
85
90
95
96
类1 个数
1
2
1
1
2
0
1
0
1
类2 个数
0
1
0
0
1
1
1
1
0
(2) 生成候选分割点
相邻两个取值的中点共有 9 − 1 = 8 9-1=8 9 − 1 = 8 t t t D D D T 2 ≤ t T2 \leq t T 2 ≤ t T 2 > t T2 > t T 2 > t
(3) 逐一计算各候选点的信息增益
以 t = 82.5 t=82.5 t = 82.5 T 2 ≤ 82.5 T2 \leq 82.5 T 2 ≤ 82.5 T 2 > 82.5 T2 > 82.5 T 2 > 82.5
H ( S ∣ T 2 , t = 82.5 ) = 9 14 × ( − 7 9 log 2 7 9 − 2 9 log 2 2 9 ) + 5 14 × ( − 2 5 log 2 2 5 − 3 5 log 2 3 5 ) H(S|T2, t{=}82.5) = \frac{9}{14}\times\left(-\frac{7}{9}\log_2\frac{7}{9}-\frac{2}{9}\log_2\frac{2}{9}\right) + \frac{5}{14}\times\left(-\frac{2}{5}\log_2\frac{2}{5}-\frac{3}{5}\log_2\frac{3}{5}\right) H ( S ∣ T 2 , t = 82.5 ) = 14 9 × ( − 9 7 log 2 9 7 − 9 2 log 2 9 2 ) + 14 5 × ( − 5 2 log 2 5 2 − 5 3 log 2 5 3 ) ≈ 9 14 × 0.764 + 5 14 × 0.971 ≈ 0.838 bit \approx \frac{9}{14}\times 0.764 + \frac{5}{14}\times 0.971 \approx 0.838 \text{ bit} ≈ 14 9 × 0.764 + 14 5 × 0.971 ≈ 0.838 bit G a i n ( D , T 2 , t = 82.5 ) = 0.940 − 0.838 ≈ 0.102 bit Gain(D, T2, t{=}82.5) = 0.940 - 0.838 \approx 0.102 \text{ bit} G ain ( D , T 2 , t = 82.5 ) = 0.940 − 0.838 ≈ 0.102 bit 对其余候选点采用相同方法计算,结果如表9-5 所示。
表9-5 T2各候选分割点的信息增益
候选点 t t t
T 2 ≤ t T2 \leq t T 2 ≤ t T 2 > t T2 > t T 2 > t 条件熵 / bit
信息增益 / bit
67.5
1 / 0
8 / 5
0.893
0.048
72.5
3 / 1
6 / 4
0.925
0.015
76.5
4 / 1
5 / 4
0.895
0.045
79
5 / 1
4 / 4
0.850
0.090
82.5 7 / 2 2 / 3 0.838 0.102
87.5
7 / 3
2 / 2
0.915
0.025
92.5
8 / 4
1 / 1
0.930
0.010
95.5
8 / 5
1 / 0
0.893
0.048
(4) 确定最优分割点并计算信息增益比
t ∗ = 82.5 t^*=82.5 t ∗ = 82.5 T 2 ≤ 82.5 T2 \leq 82.5 T 2 ≤ 82.5 T 2 > 82.5 T2 > 82.5 T 2 > 82.5 S p l i t I n f o T 2 ( D ) = − 9 14 log 2 9 14 − 5 14 log 2 5 14 ≈ 0.940 bit SplitInfo_{T2}(D) = -\frac{9}{14}\log_2\frac{9}{14} - \frac{5}{14}\log_2\frac{5}{14} \approx 0.940 \text{ bit} S pl i t I n f o T 2 ( D ) = − 14 9 log 2 14 9 − 14 5 log 2 14 5 ≈ 0.940 bit
G a i n R a t i o ( D , T 2 ) = 0.102 0.940 ≈ 0.109 GainRatio(D, T2) = \frac{0.102}{0.940} \approx 0.109 G ain R a t i o ( D , T 2 ) = 0.940 0.102 ≈ 0.109 该值小于 T1 的信息增益比 0.156。因此,仅就这两个属性而言,C4.5 将优先选择 T1 作为根节点的分裂属性。
3. CART 算法
由 Breiman 等人在 1984 年提出。CART 构建的是二叉树 ,使用**基尼指数(Gini Index)**作为特征选择标准。
对于数据集 D D D m m m i i i p i p_i p i G i n i ( D ) = 1 − ∑ i = 1 m p i 2 (9-8) Gini(D) = 1 - \sum_{i=1}^{m} p_i^2 \tag{9-8} G ini ( D ) = 1 − i = 1 ∑ m p i 2 ( 9-8 )
基尼值反映了从数据集中随机抽取两个样本,其类别标记不一致的概率。G i n i ( D ) Gini(D) G ini ( D ) D D D
对于特征 A A A a a a D D D D 1 = { x ∈ D ∣ A ( x ) = a } D_1 = \{x \in D | A(x) = a\} D 1 = { x ∈ D ∣ A ( x ) = a } D 2 = D ∖ D 1 D_2 = D \setminus D_1 D 2 = D ∖ D 1 基尼指数 为:
G i n i _ i n d e x ( D , A = a ) = ∣ D 1 ∣ ∣ D ∣ G i n i ( D 1 ) + ∣ D 2 ∣ ∣ D ∣ G i n i ( D 2 ) (9-9) Gini\_index(D, A=a) = \frac{|D_1|}{|D|} Gini(D_1) + \frac{|D_2|}{|D|} Gini(D_2) \tag{9-9} G ini _ in d e x ( D , A = a ) = ∣ D ∣ ∣ D 1 ∣ G ini ( D 1 ) + ∣ D ∣ ∣ D 2 ∣ G ini ( D 2 ) ( 9-9 )
CART 算法遍历所有特征的所有可能取值(或二分点),选择使基尼指数最小的特征及其取值作为最优分裂点:
A ∗ , a ∗ = arg min A , a G i n i _ i n d e x ( D , A = a ) (9-10) A^*, a^* = \arg\min_{A, a} Gini\_index(D, A=a) \tag{9-10} A ∗ , a ∗ = arg A , a min G ini _ in d e x ( D , A = a ) ( 9-10 )
对于回归树,CART 使用平方误差或绝对误差度量节点不纯度,选择使划分后误差下降最大的特征和切分点。
计算示例 :仍以表9-2 的数据为例,用 CART 算法选择根节点的分裂属性。
(1) 计算数据集的基尼值
14 个样本中类1 有 9 个,类2 有 5 个,则:
G i n i ( D ) = 1 − ( 9 14 ) 2 − ( 5 14 ) 2 ≈ 0.459 Gini(D) = 1 - \left(\frac{9}{14}\right)^2 - \left(\frac{5}{14}\right)^2 \approx 0.459 G ini ( D ) = 1 − ( 14 9 ) 2 − ( 14 5 ) 2 ≈ 0.459
(2) 枚举候选二分划分
CART 只生成二叉树,因此每个划分都将 D D D
离散属性 T1 有 A、B、C 三个取值,对应 3 种二分方式:{ A } \{A\} { A } { B , C } \{B,C\} { B , C } { B } \{B\} { B } { A , C } \{A,C\} { A , C } { C } \{C\} { C } { A , B } \{A,B\} { A , B }
离散属性 T3 有 0、1 两个取值,对应 1 种二分方式。
连续属性 T2 与 C4.5 相同,取相邻取值的中点作为候选分割点,共 8 个,划分为 T 2 ≤ t T2 \leq t T 2 ≤ t T 2 > t T2 > t T 2 > t
(3) 计算各划分的基尼指数
以 T 1 = B T1 = B T 1 = B D 1 D_1 D 1 D 2 D_2 D 2 G i n i ( D 1 ) = 1 − 1 2 − 0 2 = 0 , G i n i ( D 2 ) = 1 − 0.5 2 − 0.5 2 = 0.5 Gini(D_1) = 1 - 1^2 - 0^2 = 0,\qquad Gini(D_2) = 1 - 0.5^2 - 0.5^2 = 0.5 G ini ( D 1 ) = 1 − 1 2 − 0 2 = 0 , G ini ( D 2 ) = 1 − 0. 5 2 − 0. 5 2 = 0.5 G i n i _ i n d e x ( D , T 1 = B ) = 4 14 × 0 + 10 14 × 0.5 ≈ 0.357 Gini\_index(D, T1=B) = \frac{4}{14}\times 0 + \frac{10}{14}\times 0.5 \approx 0.357 G ini _ in d e x ( D , T 1 = B ) = 14 4 × 0 + 14 10 × 0.5 ≈ 0.357
其余划分的计算方法相同,结果如表9-6 所示。
表9-6 各候选划分的基尼指数
属性
划分方式
D 1 D_1 D 1 D 2 D_2 D 2 基尼指数
T1
T 1 = A T1 = A T 1 = A 2 / 3
7 / 2
0.394
T1
T 1 = B T1 = B T 1 = B 4 / 0 5 / 5 0.357
T1
T 1 = C T1 = C T 1 = C 3 / 2
6 / 3
0.457
T2
T 2 ≤ 67.5 T2 \leq 67.5 T 2 ≤ 67.5 1 / 0
8 / 5
0.440
T2
T 2 ≤ 72.5 T2 \leq 72.5 T 2 ≤ 72.5 3 / 1
6 / 4
0.450
T2
T 2 ≤ 76.5 T2 \leq 76.5 T 2 ≤ 76.5 4 / 1
5 / 4
0.432
T2
T 2 ≤ 79 T2 \leq 79 T 2 ≤ 79 5 / 1
4 / 4
0.405
T2
T 2 ≤ 82.5 T2 \leq 82.5 T 2 ≤ 82.5 7 / 2
2 / 3
0.394
T2
T 2 ≤ 87.5 T2 \leq 87.5 T 2 ≤ 87.5 7 / 3
2 / 2
0.443
T2
T 2 ≤ 92.5 T2 \leq 92.5 T 2 ≤ 92.5 8 / 4
1 / 1
0.452
T2
T 2 ≤ 95.5 T2 \leq 95.5 T 2 ≤ 95.5 8 / 5
1 / 0
0.440
T3
T 3 = 1 T3 = 1 T 3 = 1 T 3 = 0 T3 = 0 T 3 = 0 3 / 3
6 / 2
0.429
(4) 选择最优分裂点
基尼指数最小的划分为 T 1 = B T1 = B T 1 = B 0.459 − 0.357 ≈ 0.102 0.459 - 0.357 \approx 0.102 0.459 − 0.357 ≈ 0.102
表9-7 ID3、C4.5与CART算法对比
特性
ID3
C4.5
CART
分裂准则
信息增益
信息增益比
基尼指数
树结构
多叉树
多叉树
二叉树
属性类型
仅离散
离散+连续
离散+连续
缺失值处理
不支持
支持
支持
剪枝
无
悲观剪枝
代价复杂度剪枝
任务类型
分类
分类
分类+回归
9.4.3 树剪枝技术
如果决策树生长得过于茂盛,它会过度拟合训练数据中的噪声和细节,导致在面对新数据时预测表现糟糕,这被称为过拟合(Over-fitting) 。
剪枝(Pruning) 技术通过剪掉那些统计意义不显著的分支,将模型简化,从而提高泛化能力。
(1) 预剪枝(Pre-pruning) :在树生长过程中,对每个节点在划分前进行评估。若当前划分不能带来验证集上准确率的提升,则停止划分,将该节点标记为叶节点。常用的停止条件包括:
节点包含的样本数小于阈值
所有特征的信息增益(或基尼指数下降)小于阈值 ϵ \epsilon ϵ
树的深度达到预设的最大值
(2) 后剪枝(Post-pruning) :先让树完全生长,再自底向上评估每个内部节点。若将某子树替换为叶节点后,模型在验证集上的准确率不降低(或下降可接受),则进行剪枝。CART 算法的**代价复杂度剪枝(Cost-Complexity Pruning)**定义如下:
C α ( T ) = C ( T ) + α ∣ T ∣ (9-11) C_\alpha(T) = C(T) + \alpha |T| \tag{9-11} C α ( T ) = C ( T ) + α ∣ T ∣ ( 9-11 ) C ( T ) C(T) C ( T ) T T T ∣ T ∣ |T| ∣ T ∣ α ≥ 0 \alpha \geq 0 α ≥ 0 α \alpha α
适用性 :预剪枝计算开销小,但存在"欠拟合"风险;后剪枝保留了更多分支信息,泛化能力通常优于预剪枝,但计算代价较高。实际应用中后剪枝更为常用。
9.5 关联规则挖掘
9.5.1 关联规则问题
关联规则挖掘用于发现事务数据中项集之间的频繁联系。零售业中常被引用的“啤酒与尿布”案例说明,某些看似不相关的商品可能具有稳定的共同购买模式。设 I = { i 1 , i 2 , … , i m } I=\{i_1,i_2,\ldots,i_m\} I = { i 1 , i 2 , … , i m } D D D T T T I I I A ⇒ B A \Rightarrow B A ⇒ B A A A B B B
9.5.2 支持度、置信度与提升度
为筛选具有统计意义和业务价值的规则,需要同时考察支持度、置信度和提升度。
支持度 衡量规则在事务数据库中的普遍程度,即项集 A ∪ B A \cup B A ∪ B s u p p o r t ( A ⇒ B ) = P ( A ∪ B ) (9-12) support(A \Rightarrow B) = P(A \cup B) \tag{9-12} s u pp or t ( A ⇒ B ) = P ( A ∪ B ) ( 9-12 ) 置信度 衡量规则的可靠性,即在出现 A A A B B B c o n f i d e n c e ( A ⇒ B ) = P ( B ∣ A ) = s u p p o r t ( A ∪ B ) s u p p o r t ( A ) (9-13) confidence(A \Rightarrow B) = P(B|A) = \frac{support(A \cup B)}{support(A)} \tag{9-13} co n f i d e n ce ( A ⇒ B ) = P ( B ∣ A ) = s u pp or t ( A ) s u pp or t ( A ∪ B ) ( 9-13 ) 提升度 比较规则的置信度与 B B B L i f t ( A , B ) = P ( A ∪ B ) P ( A ) P ( B ) (9-14) Lift(A, B) = \frac{P(A \cup B)}{P(A)P(B)} \tag{9-14} L i f t ( A , B ) = P ( A ) P ( B ) P ( A ∪ B ) ( 9-14 )
计算示例 :设某商店的购物篮事务数据库如表9-8 所示。数据库共有 4 条事务,TID 为事务编号,右列为该事务中顾客购买的商品(以 A~F 表示 6 种商品)。设最小支持度为 50%,最小置信度为 50%,下面计算规则的支持度、置信度和提升度,并判断其是否为强规则。
表9-8 购物篮事务示例
TID
购买的 item
2000
A, B, C
1000
A, C
4000
A, D
5000
B, E, F
(1) 统计项集的支持度
表9-9 项集的支持度统计
项集
包含它的事务
出现次数
支持度
{ A } \{A\} { A } 2000、1000、4000
3
75%
{ B } \{B\} { B } 2000、5000
2
50%
{ C } \{C\} { C } 2000、1000
2
50%
{ A , C } \{A,C\} { A , C } 2000、1000
2
50%
{ A , B } \{A,B\} { A , B } 2000
1
25%
(2) 计算规则的支持度、置信度和提升度
以规则 A ⇒ C A \Rightarrow C A ⇒ C s u p p o r t ( A ⇒ C ) = P ( A ∪ C ) = 2 4 = 50 % support(A \Rightarrow C) = P(A \cup C) = \frac{2}{4} = 50\% s u pp or t ( A ⇒ C ) = P ( A ∪ C ) = 4 2 = 50% c o n f i d e n c e ( A ⇒ C ) = s u p p o r t ( A ∪ C ) s u p p o r t ( A ) = 50 % 75 % ≈ 66.7 % confidence(A \Rightarrow C) = \frac{support(A \cup C)}{support(A)} = \frac{50\%}{75\%} \approx 66.7\% co n f i d e n ce ( A ⇒ C ) = s u pp or t ( A ) s u pp or t ( A ∪ C ) = 75% 50% ≈ 66.7% L i f t ( A , C ) = P ( A ∪ C ) P ( A ) P ( C ) = 0.50 0.75 × 0.50 ≈ 1.33 Lift(A, C) = \frac{P(A \cup C)}{P(A)P(C)} = \frac{0.50}{0.75 \times 0.50} \approx 1.33 L i f t ( A , C ) = P ( A ) P ( C ) P ( A ∪ C ) = 0.75 × 0.50 0.50 ≈ 1.33
对规则 C ⇒ A C \Rightarrow A C ⇒ A A ⇒ B A \Rightarrow B A ⇒ B
表9-10 候选规则的评价结果
规则
支持度
置信度
提升度
是否强规则
A ⇒ C A \Rightarrow C A ⇒ C 50%
66.7%
1.33
是
C ⇒ A C \Rightarrow A C ⇒ A 50%
100%
1.33
是
A ⇒ B A \Rightarrow B A ⇒ B 25%
33.3%
0.67
否
(3) 结果解释
A ⇒ C A \Rightarrow C A ⇒ C C ⇒ A C \Rightarrow A C ⇒ A C ⇒ A C \Rightarrow A C ⇒ A 两条规则的支持度和提升度相同,但置信度不同:支持度与提升度只取决于 A ∪ C A \cup C A ∪ C
A ⇒ C A \Rightarrow C A ⇒ C A ⇒ B A \Rightarrow B A ⇒ B
9.5.3 频繁项集挖掘算法
关联规则挖掘的关键步骤是发现支持度不低于最小支持度阈值的频繁项集。项集的候选组合空间随项数呈指数增长,直接枚举通常不可行。
Apriori 算法 利用先验性质缩小搜索空间:频繁项集的任何非空子集也一定是频繁项集,因此若某项集不频繁,其所有超集都可以被剪枝。算法采用逐层搜索,先生成候选 ( k + 1 ) (k+1) ( k + 1 )
FP-growth 算法 通过构建频繁模式树(FP-tree)压缩事务数据库。树中节点记录项的出现频数,共享前缀的事务被合并到同一路径。挖掘时从条件模式基出发,递归构造条件 FP-tree,在无需生成全部候选项集的情况下发现频繁模式,通常比 Apriori 具有更高的效率。
9.5.4 计算案例(Apriori)
🎬 教学动画:Apriori 关联规则(2:08) 大型数据库中的关联规则挖掘分为两个步骤:
找出所有频繁项集 :即支持计数不低于最小支持计数的项集。大部分计算集中在这一步。由频繁项集产生强关联规则 :即同时满足最小支持度和最小置信度的规则。
设事务数据库如表9-11 所示,共 9 条事务,最小支持计数为 2(对应最小支持度 2 / 9 ≈ 22 % 2/9 \approx 22\% 2/9 ≈ 22%
表9-11 事务数据库
TID
List of item_IDs
T100
I1, I2, I5
T200
I2, I4
T300
I2, I3
T400
I1, I2, I4
T500
I1, I3
T600
I2, I3
T700
I1, I3
T800
I1, I2, I3, I5
T900
I1, I2, I3
1. 用 Apriori算法找出所有频繁项集
Apriori 采用逐层搜索:先由频繁 k k k L k L_k L k ( k + 1 ) (k+1) ( k + 1 ) C k + 1 C_{k+1} C k + 1 L k + 1 L_{k+1} L k + 1 Apriori 性质 :频繁项集的所有非空子集必定也是频繁的;反之,只要有一个子集不频繁,该项集就一定不频繁,可直接剪枝而无需扫描数据库。
(1) 第 1 次扫描:生成 C 1 C_1 C 1 L 1 L_1 L 1
将每个单项都作为候选 1-项集,扫描数据库统计支持计数:
表9-12 候选1-项集的支持计数
候选 1-项集
支持计数
是否频繁(≥ 2 \geq 2 ≥ 2
{ I 1 } \{I_1\} { I 1 } 6
是
{ I 2 } \{I_2\} { I 2 } 7
是
{ I 3 } \{I_3\} { I 3 } 6
是
{ I 4 } \{I_4\} { I 4 } 2
是
{ I 5 } \{I_5\} { I 5 } 2
是
5 个单项的支持计数均不小于 2,因此 L 1 = { { I 1 } , { I 2 } , { I 3 } , { I 4 } , { I 5 } } L_1=\{\{I_1\},\{I_2\},\{I_3\},\{I_4\},\{I_5\}\} L 1 = {{ I 1 } , { I 2 } , { I 3 } , { I 4 } , { I 5 }}
(2) 第 2 次扫描:生成 C 2 C_2 C 2 L 2 L_2 L 2
将 L 1 L_1 L 1 ( 5 2 ) = 10 \binom{5}{2}=10 ( 2 5 ) = 10 L 1 L_1 L 1
表9-13 候选2-项集的支持计数
候选 2-项集
包含它的事务
支持计数
是否频繁
{ I 1 , I 2 } \{I_1,I_2\} { I 1 , I 2 } T100、T400、T800、T900
4
是
{ I 1 , I 3 } \{I_1,I_3\} { I 1 , I 3 } T500、T700、T800、T900
4
是
{ I 1 , I 4 } \{I_1,I_4\} { I 1 , I 4 } T400
1
否
{ I 1 , I 5 } \{I_1,I_5\} { I 1 , I 5 } T100、T800
2
是
{ I 2 , I 3 } \{I_2,I_3\} { I 2 , I 3 } T300、T600、T800、T900
4
是
{ I 2 , I 4 } \{I_2,I_4\} { I 2 , I 4 } T200、T400
2
是
{ I 2 , I 5 } \{I_2,I_5\} { I 2 , I 5 } T100、T800
2
是
{ I 3 , I 4 } \{I_3,I_4\} { I 3 , I 4 } 无
0
否
{ I 3 , I 5 } \{I_3,I_5\} { I 3 , I 5 } T800
1
否
{ I 4 , I 5 } \{I_4,I_5\} { I 4 , I 5 } 无
0
否
删除不满足最小支持计数的 { I 1 , I 4 } \{I_1,I_4\} { I 1 , I 4 } { I 3 , I 4 } \{I_3,I_4\} { I 3 , I 4 } { I 3 , I 5 } \{I_3,I_5\} { I 3 , I 5 } { I 4 , I 5 } \{I_4,I_5\} { I 4 , I 5 } L 2 = { { I 1 , I 2 } , { I 1 , I 3 } , { I 1 , I 5 } , { I 2 , I 3 } , { I 2 , I 4 } , { I 2 , I 5 } } L_2=\{\{I_1,I_2\},\{I_1,I_3\},\{I_1,I_5\},\{I_2,I_3\},\{I_2,I_4\},\{I_2,I_5\}\} L 2 = {{ I 1 , I 2 } , { I 1 , I 3 } , { I 1 , I 5 } , { I 2 , I 3 } , { I 2 , I 4 } , { I 2 , I 5 }}
(3) 第 3 次扫描:生成 C 3 C_3 C 3 L 3 L_3 L 3
连接 :若 L 2 L_2 L 2 k − 2 = 1 k-2=1 k − 2 = 1
{ I 1 , I 2 , I 3 } \{I_1,I_2,I_3\} { I 1 , I 2 , I 3 } { I 1 , I 2 , I 5 } \{I_1,I_2,I_5\} { I 1 , I 2 , I 5 } { I 1 , I 3 , I 5 } \{I_1,I_3,I_5\} { I 1 , I 3 , I 5 } { I 2 , I 3 , I 4 } \{I_2,I_3,I_4\} { I 2 , I 3 , I 4 } { I 2 , I 3 , I 5 } \{I_2,I_3,I_5\} { I 2 , I 3 , I 5 } { I 2 , I 4 , I 5 } \{I_2,I_4,I_5\} { I 2 , I 4 , I 5 }
剪枝 :利用 Apriori 性质检查每个候选的所有 2-项子集是否都在 L 2 L_2 L 2
表9-14 候选3-项集的剪枝检查
候选 3-项集
2-项子集
不在 L 2 L_2 L 2
结果
{ I 1 , I 2 , I 3 } \{I_1,I_2,I_3\} { I 1 , I 2 , I 3 } { I 1 , I 2 } \{I_1,I_2\} { I 1 , I 2 } { I 1 , I 3 } \{I_1,I_3\} { I 1 , I 3 } { I 2 , I 3 } \{I_2,I_3\} { I 2 , I 3 } 无
保留
{ I 1 , I 2 , I 5 } \{I_1,I_2,I_5\} { I 1 , I 2 , I 5 } { I 1 , I 2 } \{I_1,I_2\} { I 1 , I 2 } { I 1 , I 5 } \{I_1,I_5\} { I 1 , I 5 } { I 2 , I 5 } \{I_2,I_5\} { I 2 , I 5 } 无
保留
{ I 1 , I 3 , I 5 } \{I_1,I_3,I_5\} { I 1 , I 3 , I 5 } { I 1 , I 3 } \{I_1,I_3\} { I 1 , I 3 } { I 1 , I 5 } \{I_1,I_5\} { I 1 , I 5 } { I 3 , I 5 } \{I_3,I_5\} { I 3 , I 5 } { I 3 , I 5 } \{I_3,I_5\} { I 3 , I 5 } 剪枝
{ I 2 , I 3 , I 4 } \{I_2,I_3,I_4\} { I 2 , I 3 , I 4 } { I 2 , I 3 } \{I_2,I_3\} { I 2 , I 3 } { I 2 , I 4 } \{I_2,I_4\} { I 2 , I 4 } { I 3 , I 4 } \{I_3,I_4\} { I 3 , I 4 } { I 3 , I 4 } \{I_3,I_4\} { I 3 , I 4 } 剪枝
{ I 2 , I 3 , I 5 } \{I_2,I_3,I_5\} { I 2 , I 3 , I 5 } { I 2 , I 3 } \{I_2,I_3\} { I 2 , I 3 } { I 2 , I 5 } \{I_2,I_5\} { I 2 , I 5 } { I 3 , I 5 } \{I_3,I_5\} { I 3 , I 5 } { I 3 , I 5 } \{I_3,I_5\} { I 3 , I 5 } 剪枝
{ I 2 , I 4 , I 5 } \{I_2,I_4,I_5\} { I 2 , I 4 , I 5 } { I 2 , I 4 } \{I_2,I_4\} { I 2 , I 4 } { I 2 , I 5 } \{I_2,I_5\} { I 2 , I 5 } { I 4 , I 5 } \{I_4,I_5\} { I 4 , I 5 } { I 4 , I 5 } \{I_4,I_5\} { I 4 , I 5 } 剪枝
剪枝后 C 3 = { { I 1 , I 2 , I 3 } , { I 1 , I 2 , I 5 } } C_3=\{\{I_1,I_2,I_3\},\{I_1,I_2,I_5\}\} C 3 = {{ I 1 , I 2 , I 3 } , { I 1 , I 2 , I 5 }}
表9-15 候选3-项集的支持计数
候选 3-项集
包含它的事务
支持计数
是否频繁
{ I 1 , I 2 , I 3 } \{I_1,I_2,I_3\} { I 1 , I 2 , I 3 } T800、T900
2
是
{ I 1 , I 2 , I 5 } \{I_1,I_2,I_5\} { I 1 , I 2 , I 5 } T100、T800
2
是
因此 L 3 = { { I 1 , I 2 , I 3 } , { I 1 , I 2 , I 5 } } L_3=\{\{I_1,I_2,I_3\},\{I_1,I_2,I_5\}\} L 3 = {{ I 1 , I 2 , I 3 } , { I 1 , I 2 , I 5 }}
(4) 生成 C 4 C_4 C 4
将 L 3 L_3 L 3 { I 1 , I 2 , I 3 , I 5 } \{I_1,I_2,I_3,I_5\} { I 1 , I 2 , I 3 , I 5 } { I 2 , I 3 , I 5 } \{I_2,I_3,I_5\} { I 2 , I 3 , I 5 } L 3 L_3 L 3 C 4 = ∅ C_4=\varnothing C 4 = ∅
所有频繁项集为 L 1 ∪ L 2 ∪ L 3 L_1 \cup L_2 \cup L_3 L 1 ∪ L 2 ∪ L 3 { I 1 , I 2 , I 3 } \{I_1,I_2,I_3\} { I 1 , I 2 , I 3 } { I 1 , I 2 , I 5 } \{I_1,I_2,I_5\} { I 1 , I 2 , I 5 }
2. 由频繁项集产生强关联规则
强关联规则 同时满足最小支持度和最小置信度。由频繁项集产生的规则必然满足最小支持度,因此只需检验置信度:
c o n f i d e n c e ( A ⇒ B ) = P ( B ∣ A ) = s u p p o r t _ c o u n t ( A ∪ B ) s u p p o r t _ c o u n t ( A ) (9-15) confidence(A \Rightarrow B) = P(B|A) = \frac{support\_count(A \cup B)}{support\_count(A)} \tag{9-15} co n f i d e n ce ( A ⇒ B ) = P ( B ∣ A ) = s u pp or t _ co u n t ( A ) s u pp or t _ co u n t ( A ∪ B ) ( 9-15 )
产生规则的过程如下:
对每个频繁项集 l l l l l l s s s
对每个非空子集 s s s s u p p o r t _ c o u n t ( l ) s u p p o r t _ c o u n t ( s ) ≥ m i n _ c o n f \dfrac{support\_count(l)}{support\_count(s)} \geq min\_conf s u pp or t _ co u n t ( s ) s u pp or t _ co u n t ( l ) ≥ min _ co n f s ⇒ ( l − s ) s \Rightarrow (l-s) s ⇒ ( l − s )
设最小置信度 m i n _ c o n f = 70 % min\_conf=70\% min _ co n f = 70%
例 1:频繁项集 l = { I 1 , I 2 , I 5 } l=\{I_1,I_2,I_5\} l = { I 1 , I 2 , I 5 } (s u p p o r t _ c o u n t ( l ) = 2 support\_count(l)=2 s u pp or t _ co u n t ( l ) = 2
l l l { I 1 , I 2 } \{I_1,I_2\} { I 1 , I 2 } { I 1 , I 5 } \{I_1,I_5\} { I 1 , I 5 } { I 2 , I 5 } \{I_2,I_5\} { I 2 , I 5 } { I 1 } \{I_1\} { I 1 } { I 2 } \{I_2\} { I 2 } { I 5 } \{I_5\} { I 5 }
表9-16 频繁项集{I1,I2,I5}的候选规则
候选规则
置信度计算
置信度
是否强规则
I 1 ∧ I 2 ⇒ I 5 I_1 \wedge I_2 \Rightarrow I_5 I 1 ∧ I 2 ⇒ I 5 2 / 4 2/4 2/4 50%
否
I 1 ∧ I 5 ⇒ I 2 I_1 \wedge I_5 \Rightarrow I_2 I 1 ∧ I 5 ⇒ I 2 2 / 2 2/2 2/2 100%
是
I 2 ∧ I 5 ⇒ I 1 I_2 \wedge I_5 \Rightarrow I_1 I 2 ∧ I 5 ⇒ I 1 2 / 2 2/2 2/2 100%
是
I 1 ⇒ I 2 ∧ I 5 I_1 \Rightarrow I_2 \wedge I_5 I 1 ⇒ I 2 ∧ I 5 2 / 6 2/6 2/6 33%
否
I 2 ⇒ I 1 ∧ I 5 I_2 \Rightarrow I_1 \wedge I_5 I 2 ⇒ I 1 ∧ I 5 2 / 7 2/7 2/7 29%
否
I 5 ⇒ I 1 ∧ I 2 I_5 \Rightarrow I_1 \wedge I_2 I 5 ⇒ I 1 ∧ I 2 2 / 2 2/2 2/2 100%
是
其中分母分别为 s u p p o r t _ c o u n t ( { I 1 , I 2 } ) = 4 support\_count(\{I_1,I_2\})=4 s u pp or t _ co u n t ({ I 1 , I 2 }) = 4 s u p p o r t _ c o u n t ( { I 1 , I 5 } ) = 2 support\_count(\{I_1,I_5\})=2 s u pp or t _ co u n t ({ I 1 , I 5 }) = 2 s u p p o r t _ c o u n t ( { I 2 , I 5 } ) = 2 support\_count(\{I_2,I_5\})=2 s u pp or t _ co u n t ({ I 2 , I 5 }) = 2 s u p p o r t _ c o u n t ( { I 1 } ) = 6 support\_count(\{I_1\})=6 s u pp or t _ co u n t ({ I 1 }) = 6 s u p p o r t _ c o u n t ( { I 2 } ) = 7 support\_count(\{I_2\})=7 s u pp or t _ co u n t ({ I 2 }) = 7 s u p p o r t _ c o u n t ( { I 5 } ) = 2 support\_count(\{I_5\})=2 s u pp or t _ co u n t ({ I 5 }) = 2 I 1 ∧ I 5 ⇒ I 2 , I 2 ∧ I 5 ⇒ I 1 , I 5 ⇒ I 1 ∧ I 2 I_1 \wedge I_5 \Rightarrow I_2,\qquad I_2 \wedge I_5 \Rightarrow I_1,\qquad I_5 \Rightarrow I_1 \wedge I_2 I 1 ∧ I 5 ⇒ I 2 , I 2 ∧ I 5 ⇒ I 1 , I 5 ⇒ I 1 ∧ I 2
例 2:频繁项集 l = { I 1 , I 2 , I 3 } l=\{I_1,I_2,I_3\} l = { I 1 , I 2 , I 3 } (s u p p o r t _ c o u n t ( l ) = 2 support\_count(l)=2 s u pp or t _ co u n t ( l ) = 2
表9-17 频繁项集{I1,I2,I3}的候选规则
候选规则
置信度计算
置信度
是否强规则
I 1 ∧ I 2 ⇒ I 3 I_1 \wedge I_2 \Rightarrow I_3 I 1 ∧ I 2 ⇒ I 3 2 / 4 2/4 2/4 50%
否
I 1 ∧ I 3 ⇒ I 2 I_1 \wedge I_3 \Rightarrow I_2 I 1 ∧ I 3 ⇒ I 2 2 / 4 2/4 2/4 50%
否
I 2 ∧ I 3 ⇒ I 1 I_2 \wedge I_3 \Rightarrow I_1 I 2 ∧ I 3 ⇒ I 1 2 / 4 2/4 2/4 50%
否
I 1 ⇒ I 2 ∧ I 3 I_1 \Rightarrow I_2 \wedge I_3 I 1 ⇒ I 2 ∧ I 3 2 / 6 2/6 2/6 33%
否
I 2 ⇒ I 1 ∧ I 3 I_2 \Rightarrow I_1 \wedge I_3 I 2 ⇒ I 1 ∧ I 3 2 / 7 2/7 2/7 29%
否
I 3 ⇒ I 1 ∧ I 2 I_3 \Rightarrow I_1 \wedge I_2 I 3 ⇒ I 1 ∧ I 2 2 / 6 2/6 2/6 33%
否
该频繁项集没有产生任何强关联规则。可见频繁项集只保证规则满足最小支持度,是否成为强规则还取决于置信度。对其余频繁项集(如 2-项集),按同样的方法逐一检验即可。
9.5.5 其他关联规则
前面讨论的关联规则都是布尔关联规则 :只关心某个项在事务中出现还是未出现(取值为 1 或 0,Yes or No),不关心购买数量或价格;规则涉及的项也都处于同一抽象层次,例如“购买牛奶的顾客通常也会购买面包”。这类规则是离散的、二元的关系。
现实数据往往更加复杂:事务中除商品外还带有年龄、性别、收入等属性,属性可以是数值型,商品之间还存在“品牌—品类—大类”的层次关系。针对这些情形,关联规则可以扩展为多维关联规则、量化关联规则和多层次关联规则,它们的共同思路是先把数据转换为布尔形式,再沿用 Apriori 等算法求解 。
1. 多维关联规则
Apriori 算法天生为“购物篮”设计,只有“物品”这一个维度。如果要同时考虑用户的性别、年龄、地区等多个维度,可采用单维化处理 :把各维属性“压扁”,伪装成普通的项(item),再用 Apriori 算法挖掘。例如,规则 年龄_20-30 ∧ 性别_男 ⇒ 啤酒 同时涉及年龄、性别和商品三个维度。
设原始数据如表9-18 所示:
表9-18 带有用户属性的事务数据
交易 ID
年龄(数值)
性别(类别)
年收入(数值)
购买的商品(事务)
T001
25
男
8000
牛奶, 面包
T002
45
女
25000
红酒, 奶酪
T003
26
男
9000
啤酒
第一步:量化数据离散化。 先把数值变成区间标签。
年龄:25、26 归入 [20-30岁],45 归入 [40-50岁]。
收入:8000、9000 归入 [中低收入],25000 归入 [高收入]。
第二步:属性标签化。 把“列名”和“值”拼接起来,变成项。例如,性别“男”变成项 性别_男,年龄区间 [20-30岁] 变成项 年龄_20-30。
第三步:合并入篮(扁平化)。 将每条事务的所有属性项与商品项合并到同一个“超级购物篮”中,如表9-19 所示。
表9-19 扁平化后的超级购物篮
交易 ID
超级购物篮(处理后的项集)
T001
{年龄_20-30, 性别_男, 收入_中低, 牛奶, 面包}
T002
{年龄_40-50, 性别_女, 收入_高, 红酒, 奶酪}
T003
{年龄_20-30, 性别_男, 收入_中低, 啤酒}
进一步可将项集转换为布尔矩阵(One-Hot 编码),出现记为 1,未出现记为 0,如表9-20 所示。此后即可直接套用前述的 Apriori 算法。
表9-20 布尔矩阵(One-Hot编码)
交易 ID
年龄_20-30
年龄_40-50
性别_男
性别_女
收入_中低
收入_高
牛奶
面包
红酒
奶酪
啤酒
T001
1
0
1
0
1
0
1
1
0
0
0
T002
0
1
0
1
0
1
0
0
1
1
0
T003
1
0
1
0
1
0
0
0
0
0
1
2. 量化关联规则
量化关联规则处理的数据包含数值属性。它不再是简单的“买没买”,而是涉及“买了多少”“年龄多大”“收入多少”这类量化概念,通常需要把连续的数字划分为区间,再寻找规律。
难点在于区间如何划分 :按 10 岁一段还是按 5 岁一段,会使挖掘出的规则完全不同。区间过窄,每个区间的支持度偏低,规则可能达不到最小支持度;区间过宽,规则的置信度又会被稀释。核心思路是先把“量化”问题变成“布尔”问题,再用 Apriori 或其他算法求解。常见的处理方式有三种:
(1) 静态离散化(Static Discretization)
在挖掘之前,预先把数值划分为区间(分箱),然后将区间作为布尔属性。例如,原数据为年龄 = 23、24、25、26、27……,处理后变为布尔属性“青年”(20-30 岁)和“中年”(30-50 岁)。常见的切分策略有:
等宽分箱 :每个区间的宽度相同,例如每 10 岁一档。等频分箱 :每个区间包含的记录数大致相同。
(2) 基于聚类的处理(Clustering-based)
利用聚类算法(如 k-means)对量化属性进行处理:
把所有人的“收入”“年龄”等属性投射到坐标系上;
观察数据点在哪里最密集,让算法自动聚成若干簇;
给每一簇起一个名字(如 A 类人群、B 类人群);
用簇的 ID 替换原来的数值,再运行 Apriori。
(3) 动态量化关联规则挖掘
这类算法(如 Srikant 和 Agrawal 提出的方法)不预先固定区间,而是在挖掘过程中动态合并相邻区间。算法先从细粒度区间开始(20-21 岁、21-22 岁……),如果发现“20-21 岁”和“21-22 岁”都与“购买啤酒”有关联,就自动把它们合并为“20-22 岁”,从而提高支持度。
3. 多层次关联规则
商品之间通常存在概念分层,例如“电子产品 → 笔记本电脑 → 联想笔记本 → 联想 X1 Carbon”。多层次关联规则 在不同抽象层次上挖掘规则:高层规则概括性强,低层规则更具体。主要有三种挖掘策略。
(1) 自顶向下策略(Top-Down Strategy)
先在最高层的“大类”上找规则;若大类之间存在关联,再向下展开到下一层继续挖掘;若大类之间没有关联,则其下的小类直接放弃(剪枝)。
表9-21 自顶向下挖掘策略示例
层级
挖掘对象
发现的规则
处理
1
大类
奶制品 ⇒ 面包类(支持度很高)
保留,继续向下展开
2
子类
纯牛奶 ⇒ 全麦面包(支持度不错)
保留,继续向下展开
2
子类
酸奶 ⇒ 牛角包(支持度太低)
丢弃
3
更细的层次
……
继续向下 ……
(2) 层级独立的支持度策略(Variable Support Strategy)
Apriori 通常只设置一个支持度阈值(如 5%),但这对多层次数据并不合适:对高层的大类,5% 太容易达到,会挖出大量无意义的规则;对底层的具体商品,5% 又太难达到,许多有价值的规则被误删。因此可以为不同层级设置不同的最小支持度阈值 :
表9-22 各层级的最小支持度设置
层级
对象
最小支持度
说明
第 1 层
大类
20%
门槛高,只保留极其普遍的规律
第 2 层
中类
5%
门槛降低
第 3 层
单品
0.5%
门槛很低,只要有少量顾客购买就算关联
(3) 同级与跨级混合挖掘(Cross-level Mining)
有时需要发现跨越层次的规则,例如“联想笔记本电脑(具体层)⇒ 鼠标(抽象层)”。做法是对数据进行全层级展开 :把一个商品同时翻译成它在各个层级上的所有身份,一并放入购物篮。
原始数据:{ 联想 X1 Carbon }
展开后:{ 联想 X1 Carbon, 联想笔记本, 笔记本电脑, 电子产品 }
展开后,算法会自动计算各种项的组合,这会产生冗余规则,例如“联想 X1 Carbon ⇒ 联想笔记本”。这类规则只是反映了概念分层本身,并没有提供新的知识。为此需要设定输出规则:若 A 是 B 的上级(或下级),则 A 与 B 之间的关联规则直接剔除,不予输出。
4. 三类扩展规则的比较
表9-23 三类扩展关联规则的比较
类型
扩展的方面
核心思路
规则示例
布尔关联规则
基础形式
只考虑项是否出现
牛奶 ⇒ 面包
多维关联规则
引入多个维度(性别、年龄、地区等)
把维属性标签化为项,单维化后用 Apriori
年龄_20-30 ∧ 性别_男 ⇒ 啤酒
量化关联规则
属性取值为数值
通过静态离散化、聚类或动态合并区间,转化为布尔问题
年龄[20-22] ⇒ 啤酒
多层次关联规则
项具有概念分层
自顶向下挖掘,分层设置支持度,跨层展开并剔除冗余规则
奶制品 ⇒ 面包类;联想笔记本 ⇒ 鼠标
9.6 聚类分析
🎬 教学动画:K-Means 聚类(3:00) 9.6.1 聚类的基本概念
聚类是一种无监督学习方法,在样本没有预先标注类别的情况下,根据对象之间的相似性将数据划分为若干簇。聚类结果应使同一簇内的对象相似度较高,不同簇之间的对象差异较大。市场细分、图像分割、文档组织和异常检测等任务经常使用聚类作为探索数据结构的方法。
9.6.2 相似性度量
聚类质量依赖相似性或距离的定义。数值型数据通常采用闵可夫斯基距离、余弦相似度和杰卡德系数等度量。
1. 闵可夫斯基距离
它是欧氏距离和曼哈顿距离的泛化表示,对于 n n n d ( i , j ) = ( ∑ k = 1 n ∣ x i k − x j k ∣ p ) 1 / p (9-16) d(i, j) = \left(\sum_{k=1}^n |x_{ik} - x_{jk}|^p\right)^{1/p} \tag{9-16} d ( i , j ) = ( k = 1 ∑ n ∣ x ik − x j k ∣ p ) 1/ p ( 9-16 )
表9-24 闵可夫斯基距离的特例
p p p 距离名称
公式
适用场景
p = 1 p=1 p = 1 曼哈顿距离
d = ∑ k = 1 n ∣ x i k − x j k ∣ d = \sum_{k=1}^n \lvert x_{ik} - x_{jk}\rvert d = ∑ k = 1 n ∣ x ik − x j k ∣ 对异常值较不敏感,适用于高维稀疏数据
p = 2 p=2 p = 2 欧氏距离
d = ∑ k = 1 n ( x i k − x j k ) 2 d = \sqrt{\sum_{k=1}^n (x_{ik} - x_{jk})^2} d = ∑ k = 1 n ( x ik − x j k ) 2 最常用,适用于低维连续数据、各维度量纲一致的场景
p → ∞ p \to \infty p → ∞ 切比雪夫距离
d = max k ∣ x i k − x j k ∣ d = \max_k \lvert x_{ik} - x_{jk}\rvert d = max k ∣ x ik − x j k ∣ 关注最大维度差异的场景
2. 余弦相似度
对于文本文档等高维稀疏向量,关注方向而非绝对距离:
cos ( x , y ) = x T y ∣ ∣ x ∣ ∣ ⋅ ∣ ∣ y ∣ ∣ = ∑ k = 1 n x k y k ∑ k = 1 n x k 2 ⋅ ∑ k = 1 n y k 2 (9-17) \cos(\mathbf{x}, \mathbf{y}) = \frac{\mathbf{x}^T \mathbf{y}}{||\mathbf{x}|| \cdot ||\mathbf{y}||} = \frac{\sum_{k=1}^n x_k y_k}{\sqrt{\sum_{k=1}^n x_k^2} \cdot \sqrt{\sum_{k=1}^n y_k^2}} \tag{9-17} cos ( x , y ) = ∣∣ x ∣∣ ⋅ ∣∣ y ∣∣ x T y = ∑ k = 1 n x k 2 ⋅ ∑ k = 1 n y k 2 ∑ k = 1 n x k y k ( 9-17 )
适用性 :适合文本向量、TF-IDF 表示的文档相似度计算。值域为 [ − 1 , 1 ] [-1, 1] [ − 1 , 1 ]
计算示例 :设两个文档的词频向量为 x = ( 2 , 1 , 0 , 1 ) \mathbf{x} = (2, 1, 0, 1) x = ( 2 , 1 , 0 , 1 ) y = ( 1 , 1 , 1 , 0 ) \mathbf{y} = (1, 1, 1, 0) y = ( 1 , 1 , 1 , 0 )
内积:x T y = 2 × 1 + 1 × 1 + 0 × 1 + 1 × 0 = 3 \mathbf{x}^T \mathbf{y} = 2\times1 + 1\times1 + 0\times1 + 1\times0 = 3 x T y = 2 × 1 + 1 × 1 + 0 × 1 + 1 × 0 = 3
向量模:∣ ∣ x ∣ ∣ = 2 2 + 1 2 + 0 2 + 1 2 = 6 ||\mathbf{x}|| = \sqrt{2^2+1^2+0^2+1^2} = \sqrt{6} ∣∣ x ∣∣ = 2 2 + 1 2 + 0 2 + 1 2 = 6 ∣ ∣ y ∣ ∣ = 1 2 + 1 2 + 1 2 + 0 2 = 3 ||\mathbf{y}|| = \sqrt{1^2+1^2+1^2+0^2} = \sqrt{3} ∣∣ y ∣∣ = 1 2 + 1 2 + 1 2 + 0 2 = 3
余弦相似度:cos ( x , y ) = 3 6 × 3 = 3 18 ≈ 0.707 \cos(\mathbf{x}, \mathbf{y}) = \dfrac{3}{\sqrt{6}\times\sqrt{3}} = \dfrac{3}{\sqrt{18}} \approx 0.707 cos ( x , y ) = 6 × 3 3 = 18 3 ≈ 0.707
结果表明这两个文档的词频方向较为接近,相似度较高。
3. 杰卡德系数
用于度量两个集合之间的相似性,常用于布尔类型或集合型数据:
J ( A , B ) = ∣ A ∩ B ∣ ∣ A ∪ B ∣ (9-18) J(A, B) = \frac{|A \cap B|}{|A \cup B|} \tag{9-18} J ( A , B ) = ∣ A ∪ B ∣ ∣ A ∩ B ∣ ( 9-18 )
适用性 :广泛应用于文本去重、推荐系统中的用户行为相似度计算。
4. 相异度(距离)计算
许多聚类算法以相异度矩阵 为基础:n n n n × n n\times n n × n d ( i , j ) d(i,j) d ( i , j ) i i i j j j d ( i , i ) = 0 d(i,i)=0 d ( i , i ) = 0 d ( i , j ) = d ( j , i ) d(i,j)=d(j,i) d ( i , j ) = d ( j , i ) d ( i , j ) d(i,j) d ( i , j )
(1) 区间标度变量
区间标度变量为连续数值,可直接采用前文的闵可夫斯基距离(欧氏距离、曼哈顿距离等)计算。为避免量纲和取值范围差异的影响,通常先进行最小-最大规范化或 z-score 标准化。
(2) 二元变量
二元变量只有 0、1 两种状态,例如 smoker 表示是否吸烟。一个对象可以包含多个二元变量。设对象 i i i j j j p p p
表9-25 二元变量的取值匹配情况
对象 j j j
对象 j j j
合计
对象 i i i q q q r r r q + r q+r q + r
对象 i i i s s s t t t s + t s+t s + t
合计 q + s q+s q + s r + t r+t r + t p p p
其中 q q q t t t r r r s s s
对称二元变量 :两种状态价值相同、权重相等,例如性别。其相似度称为恒定相似度,用简单匹配系数度量相异度:
d ( i , j ) = r + s q + r + s + t (9-19) d(i,j) = \frac{r+s}{q+r+s+t} \tag{9-19} d ( i , j ) = q + r + s + t r + s ( 9-19 ) 不对称二元变量 :两种状态的重要性不同,例如 HIV 检测中阳性远比阴性重要(两人同为阴性并不说明他们相似)。其相似度称为非恒定相似度,用 Jaccard 系数度量相异度,忽略 t t t d ( i , j ) = r + s q + r + s (9-20) d(i,j) = \frac{r+s}{q+r+s} \tag{9-20} d ( i , j ) = q + r + s r + s ( 9-20 )
对称与不对称二元变量的区别及适用情形 :二者的区别在于“两个状态是否同等重要”,这决定了“两对象同取 0”(即 t t t t t t t t t
计算示例 :病人记录如下表所示。Name 为对象标识,Gender 为对称二元变量,其余属性为不对称二元变量。取 Y 和 P(阳性)为 1,N 为 0,试按不对称二元变量计算病人间的相异度。
表9-26 病人记录示例
Name
Gender
Fever
Cough
Test-1
Test-2
Test-3
Test-4
Jack
M
Y
N
P
N
N
N
Mary
F
Y
N
P
N
P
N
Jim
M
Y
P
N
N
N
N
仅取 6 个不对称属性(Fever、Cough、Test-1~Test-4),三人的取值为 Jack = (1,0,1,0,0,0),Mary = (1,0,1,0,1,0),Jim = (1,1,0,0,0,0)。
d ( Jack , Mary ) = 0 + 1 2 + 0 + 1 ≈ 0.33 d(\text{Jack},\text{Mary}) = \frac{0+1}{2+0+1} \approx 0.33 d ( Jack , Mary ) = 2 + 0 + 1 0 + 1 ≈ 0.33 d ( Jack , Jim ) = 1 + 1 1 + 1 + 1 ≈ 0.67 d(\text{Jack},\text{Jim}) = \frac{1+1}{1+1+1} \approx 0.67 d ( Jack , Jim ) = 1 + 1 + 1 1 + 1 ≈ 0.67 d ( Jim , Mary ) = 1 + 2 1 + 1 + 2 = 0.75 d(\text{Jim},\text{Mary}) = \frac{1+2}{1+1+2} = 0.75 d ( Jim , Mary ) = 1 + 1 + 2 1 + 2 = 0.75 Jack 与 Mary 的相异度最小,说明二者病情最相似;Jim 与另两人差异较大。
(3) 类别型(标称)变量
类别型变量是二元变量的推广,可取多于两个的状态,如红、绿、蓝、黄,且取值之间没有顺序关系。设对象共有 p p p
简单匹配方法 :设 m m m i i i j j j d ( i , j ) = p − m p (9-21) d(i,j) = \frac{p-m}{p} \tag{9-21} d ( i , j ) = p p − m ( 9-21 ) 二元编码方法 :为变量的每个状态创建一个新的二元变量,并按不对称二元变量处理。例如颜色变量编码为:
表9-27 颜色变量的二元编码示例
颜色
红
绿
蓝
黄
绿
0
1
0
0
蓝
0
0
1
0
(4) 序数型变量
序数型变量的取值可以是离散的或连续的,取值之间存在顺序关系,例如职称“助教、讲师、副教授、教授”。设 f f f n n n
设第 i i i x i f x_{if} x i f r i f ∈ { 1 , … , M f } r_{if}\in\{1,\ldots,M_f\} r i f ∈ { 1 , … , M f }
将取值范围映射到 [ 0 , 1 ] [0,1] [ 0 , 1 ] z i f = r i f − 1 M f − 1 (9-22) z_{if} = \frac{r_{if}-1}{M_f-1} \tag{9-22} z i f = M f − 1 r i f − 1 ( 9-22 )
将 z i f z_{if} z i f
计算示例 :四位教师的职称为甲 = 助教、乙 = 副教授、丙 = 教授、丁 = 讲师。按从低到高排序为(助教、讲师、副教授、教授),M f = 4 M_f=4 M f = 4
表9-28 教师职称的序数编码
对象
职称
排位 r i f r_{if} r i f
z i f = r i f − 1 3 z_{if}=\frac{r_{if}-1}{3} z i f = 3 r i f − 1
甲
助教
1
0
乙
副教授
3
2/3 ≈ 0.67
丙
教授
4
1
丁
讲师
2
1/3 ≈ 0.33
例如 d ( 甲 , 乙 ) = ∣ 0 − 0.67 ∣ = 0.67 d(\text{甲},\text{乙})=|0-0.67|=0.67 d ( 甲 , 乙 ) = ∣0 − 0.67∣ = 0.67 d ( 乙 , 丙 ) = ∣ 0.67 − 1 ∣ = 0.33 d(\text{乙},\text{丙})=|0.67-1|=0.33 d ( 乙 , 丙 ) = ∣0.67 − 1∣ = 0.33 d ( 甲 , 丙 ) = 1 d(\text{甲},\text{丙})=1 d ( 甲 , 丙 ) = 1
(5) 混合类型变量
实际数据库中,对象往往由多种类型的变量共同描述。处理方式有两种:一是按变量类型分组,分别聚类,但仅当各组结果相近时才可行;二是将所有变量放在一起处理,把不同类型的变量合并为一个相异度矩阵,并将各变量的相异度统一变换到 [ 0 , 1 ] [0,1] [ 0 , 1 ] d ( i , j ) = ∑ f = 1 p δ i j ( f ) d i j ( f ) ∑ f = 1 p δ i j ( f ) (9-23) d(i,j) = \frac{\sum_{f=1}^{p}\delta_{ij}^{(f)}d_{ij}^{(f)}}{\sum_{f=1}^{p}\delta_{ij}^{(f)}} \tag{9-23} d ( i , j ) = ∑ f = 1 p δ ij ( f ) ∑ f = 1 p δ ij ( f ) d ij ( f ) ( 9-23 )
其中指示量 δ i j ( f ) \delta_{ij}^{(f)} δ ij ( f ) x i f x_{if} x i f x j f x_{jf} x j f x i f = x j f = 0 x_{if}=x_{jf}=0 x i f = x j f = 0 f f f δ i j ( f ) = 0 \delta_{ij}^{(f)}=0 δ ij ( f ) = 0 δ i j ( f ) = 1 \delta_{ij}^{(f)}=1 δ ij ( f ) = 1 f f f d i j ( f ) d_{ij}^{(f)} d ij ( f )
区间标度变量:d i j ( f ) = ∣ x i f − x j f ∣ max h x h f − min h x h f d_{ij}^{(f)}=\dfrac{|x_{if}-x_{jf}|}{\max_h x_{hf}-\min_h x_{hf}} d ij ( f ) = max h x h f − min h x h f ∣ x i f − x j f ∣ h h h f f f
二元变量或类别型变量:x i f = x j f x_{if}=x_{jf} x i f = x j f d i j ( f ) = 0 d_{ij}^{(f)}=0 d ij ( f ) = 0
序数型变量:计算 z i f = r i f − 1 M f − 1 z_{if}=\dfrac{r_{if}-1}{M_f-1} z i f = M f − 1 r i f − 1
综合示例 :四个对象的三个变量如下表所示,其中 test-1 为类别型,test-2 为序数型,test-3 为区间标度型。试分别计算各变量的相异度矩阵,再求混合相异度矩阵。
表9-29 混合类型变量示例数据
对象序号
test-1(类别型)
test-2(序数型)
test-3(区间标度型)
1
code-A
excellent
2.65
2
code-B
fair
1.34
3
code-C
good
2.11
4
code-A
excellent
3.08
① 类别型变量 test-1 :取值相同则 d = 0 d=0 d = 0 d = 1 d=1 d = 1
D 1 = [ 0 1 0 1 1 0 0 1 1 0 ] D_1=\begin{bmatrix}0\\ 1 & 0\\ 1 & 1 & 0\\ 0 & 1 & 1 & 0\end{bmatrix} D 1 = 0 1 1 0 0 1 1 0 1 0 ② 序数型变量 test-2 :状态按顺序为 fair < good < excellent,M f = 3 M_f=3 M f = 3 z z z z z z z z z
D 2 = [ 0 1 0 0.5 0.5 0 0 1 0.5 0 ] D_2=\begin{bmatrix}0\\ 1 & 0\\ 0.5 & 0.5 & 0\\ 0 & 1 & 0.5 & 0\end{bmatrix} D 2 = 0 1 0.5 0 0 0.5 1 0 0.5 0 ③ 区间标度变量 test-3 :最大值为 3.08,最小值为 1.34,极差为 1.74。采用最小-最大规范化,对象 1~4 规范化后的值依次为 0.753、0、0.443、1,相异度为规范化值之差的绝对值。例如 d ( 2 , 1 ) = ∣ 1.34 − 2.65 ∣ 1.74 ≈ 0.75 d(2,1)=\dfrac{|1.34-2.65|}{1.74}\approx 0.75 d ( 2 , 1 ) = 1.74 ∣1.34 − 2.65∣ ≈ 0.75
D 3 = [ 0 0.75 0 0.31 0.44 0 0.25 1 0.56 0 ] D_3=\begin{bmatrix}0\\ 0.75 & 0\\ 0.31 & 0.44 & 0\\ 0.25 & 1 & 0.56 & 0\end{bmatrix} D 3 = 0 0.75 0.31 0.25 0 0.44 1 0 0.56 0 ④ 混合相异度矩阵 :三个变量均无缺失,且均不是不对称二元变量,故所有 δ i j ( f ) = 1 \delta_{ij}^{(f)}=1 δ ij ( f ) = 1 d ( 2 , 1 ) = 1 + 1 + 0.75 3 ≈ 0.92 , d ( 4 , 1 ) = 0 + 0 + 0.25 3 ≈ 0.08 d(2,1)=\frac{1+1+0.75}{3}\approx 0.92,\qquad d(4,1)=\frac{0+0+0.25}{3}\approx 0.08 d ( 2 , 1 ) = 3 1 + 1 + 0.75 ≈ 0.92 , d ( 4 , 1 ) = 3 0 + 0 + 0.25 ≈ 0.08
D = [ 0 0.92 0 0.60 0.65 0 0.08 1 0.69 0 ] D=\begin{bmatrix}0\\ 0.92 & 0\\ 0.60 & 0.65 & 0\\ 0.08 & 1 & 0.69 & 0\end{bmatrix} D = 0 0.92 0.60 0.08 0 0.65 1 0 0.69 0 结果表明,对象 1 与对象 4 的相异度最小,三个变量上的取值最为接近;对象 2 与对象 4 的相异度最大。
9.6.3 典型聚类算法
1. 划分方法
k-means 算法 是应用广泛的划分聚类算法。
目标函数 :最小化所有簇内对象到其质心的平方误差和(SSE, Sum of Squared Errors):
E = ∑ i = 1 k ∑ p ∈ C i ∣ ∣ p − m i ∣ ∣ 2 (9-24) E = \sum_{i=1}^k \sum_{\mathbf{p} \in C_i} ||\mathbf{p} - \mathbf{m}_i||^2 \tag{9-24} E = i = 1 ∑ k p ∈ C i ∑ ∣∣ p − m i ∣ ∣ 2 ( 9-24 ) C i C_i C i i i i m i = 1 ∣ C i ∣ ∑ p ∈ C i p \mathbf{m}_i = \frac{1}{|C_i|}\sum_{\mathbf{p} \in C_i} \mathbf{p} m i = ∣ C i ∣ 1 ∑ p ∈ C i p C i C_i C i
算法步骤 :
随机选取 k k k
将每个对象分配到距离最近的质心所代表的簇
重新计算每个簇的质心
重复步骤 2-3,直到质心不再变化或达到最大迭代次数
适用性与局限 :k-means 算法简单高效,时间复杂度为 O ( n k t ) O(nkt) O ( nk t ) n n n k k k t t t
需要预先指定 k k k
对初始质心选取敏感(可使用 k-means++ 改进初始化)
主要适用于球形或近似球形簇,难以识别形状复杂、大小差异较大的簇
对离群值和噪声敏感
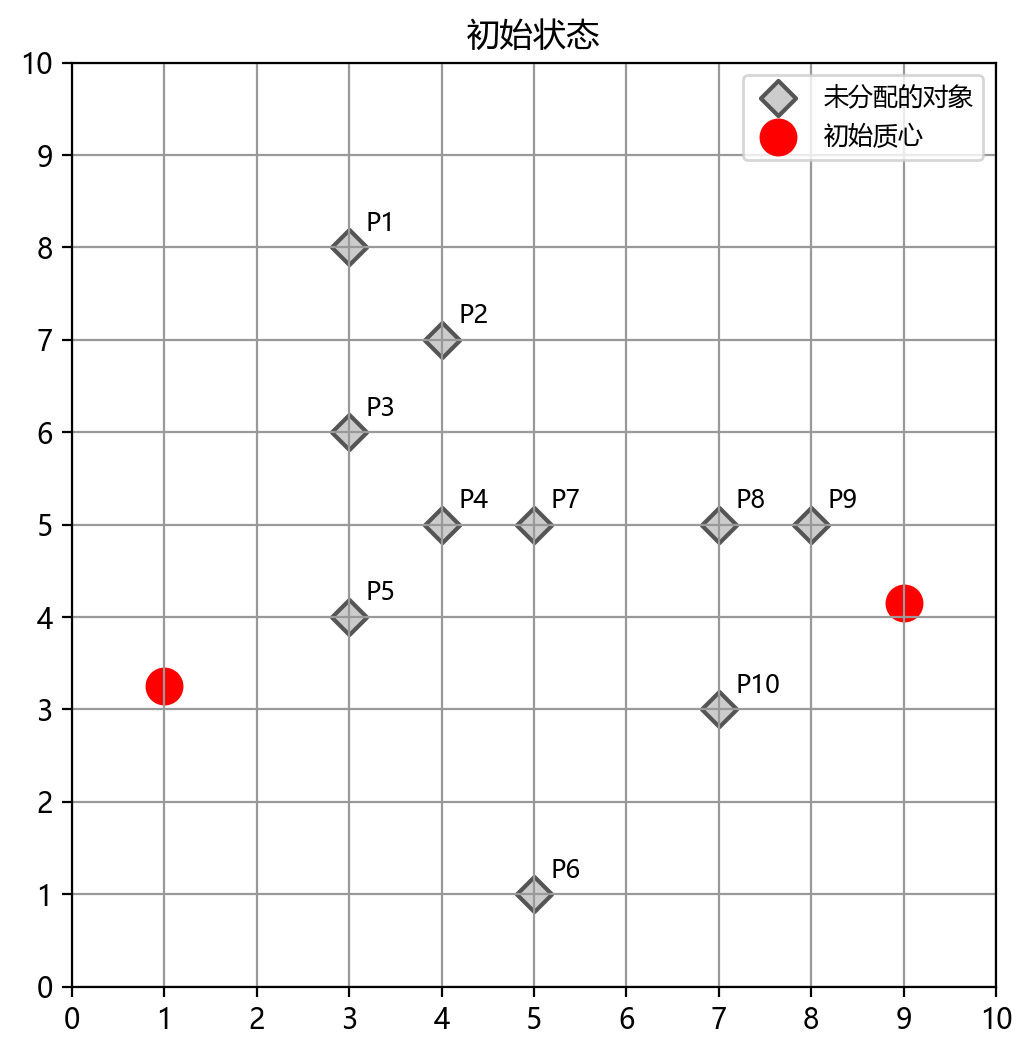
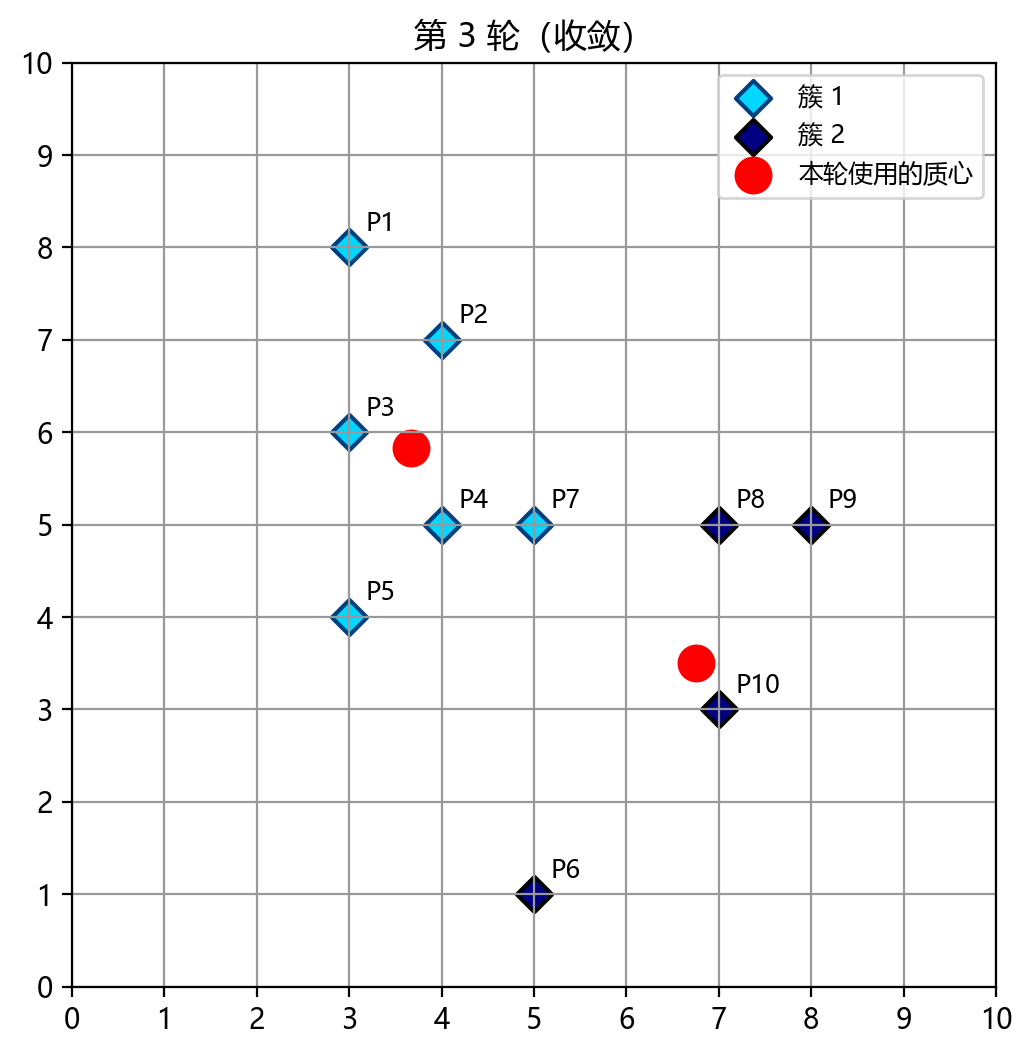
计算示例 :设二维平面上有 10 个对象 P 1 ∼ P 10 P_1\sim P_{10} P 1 ∼ P 10 k = 2 k=2 k = 2 m 1 = ( 1 , 3.25 ) m_1=(1,\,3.25) m 1 = ( 1 , 3.25 ) m 2 = ( 9 , 4.15 ) m_2=(9,\,4.15) m 2 = ( 9 , 4.15 )
表9-30 k-means示例数据对象的坐标
对象
P 1 P_1 P 1 P 2 P_2 P 2 P 3 P_3 P 3 P 4 P_4 P 4 P 5 P_5 P 5 P 6 P_6 P 6 P 7 P_7 P 7 P 8 P_8 P 8 P 9 P_9 P 9 P 10 P_{10} P 10
坐标
(3,8)
(4,7)
(3,6)
(4,5)
(3,4)
(5,1)
(5,5)
(7,5)
(8,5)
(7,3)
数据对象与初始质心的位置如图9-2(a)所示。
图9-2(a) k-means 初始状态
各轮均以欧氏距离的平方 d 2 d^2 d 2 P 1 P_1 P 1 d 2 ( P 1 , m 1 ) = ( 3 − 1 ) 2 + ( 8 − 3.25 ) 2 ≈ 26.56 , d 2 ( P 1 , m 2 ) = ( 3 − 9 ) 2 + ( 8 − 4.15 ) 2 ≈ 50.82 d^2(P_1,m_1)=(3-1)^2+(8-3.25)^2\approx 26.56,\qquad d^2(P_1,m_2)=(3-9)^2+(8-4.15)^2\approx 50.82 d 2 ( P 1 , m 1 ) = ( 3 − 1 ) 2 + ( 8 − 3.25 ) 2 ≈ 26.56 , d 2 ( P 1 , m 2 ) = ( 3 − 9 ) 2 + ( 8 − 4.15 ) 2 ≈ 50.82 P 1 P_1 P 1 m 1 m_1 m 1 d 2 d^2 d 2 d 2 d^2 d 2
表9-31 k-means三轮迭代的分配结果
对象
第 1 轮m 1 = ( 1 , 3.25 ) m_1=(1,3.25) m 1 = ( 1 , 3.25 ) m 2 = ( 9 , 4.15 ) m_2=(9,4.15) m 2 = ( 9 , 4.15 )
第 2 轮m 1 = ( 3.67 , 5.17 ) m_1=(3.67,5.17) m 1 = ( 3.67 , 5.17 ) m 2 = ( 6.75 , 4.5 ) m_2=(6.75,4.5) m 2 = ( 6.75 , 4.5 )
第 3 轮m 1 = ( 3.67 , 5.83 ) m_1=(3.67,5.83) m 1 = ( 3.67 , 5.83 ) m 2 = ( 6.75 , 3.5 ) m_2=(6.75,3.5) m 2 = ( 6.75 , 3.5 )
P 1 P_1 P 1 26.56 / 50.82 → 1
8.47 / 26.31 → 1
5.14 / 34.31 → 1
P 2 P_2 P 2 23.06 / 33.12 → 1
3.47 / 13.81 → 1
1.47 / 19.81 → 1
P 3 P_3 P 3 11.56 / 39.42 → 1
1.14 / 16.31 → 1
0.47 / 20.31 → 1
P 4 P_4 P 4 12.06 / 25.72 → 1
0.14 / 7.81 → 1
0.81 / 9.81 → 1
P 5 P_5 P 5 4.56 / 36.02 → 1
1.81 / 14.31 → 1
3.81 / 14.31 → 1
P 6 P_6 P 6 21.06 / 25.92 → 1
19.14 / 15.31 → 2
25.14 / 9.31 → 2
P 7 P_7 P 7 19.06 / 16.72 → 2
1.81 / 3.31 → 1
2.47 / 5.31 → 1
P 8 P_8 P 8 39.06 / 4.72 → 2
11.14 / 0.31 → 2
11.81 / 2.31 → 2
P 9 P_9 P 9 52.06 / 1.72 → 2
18.81 / 1.81 → 2
19.47 / 3.81 → 2
P 10 P_{10} P 10 36.06 / 5.32 → 2
15.81 / 2.31 → 2
19.14 / 0.31 → 2
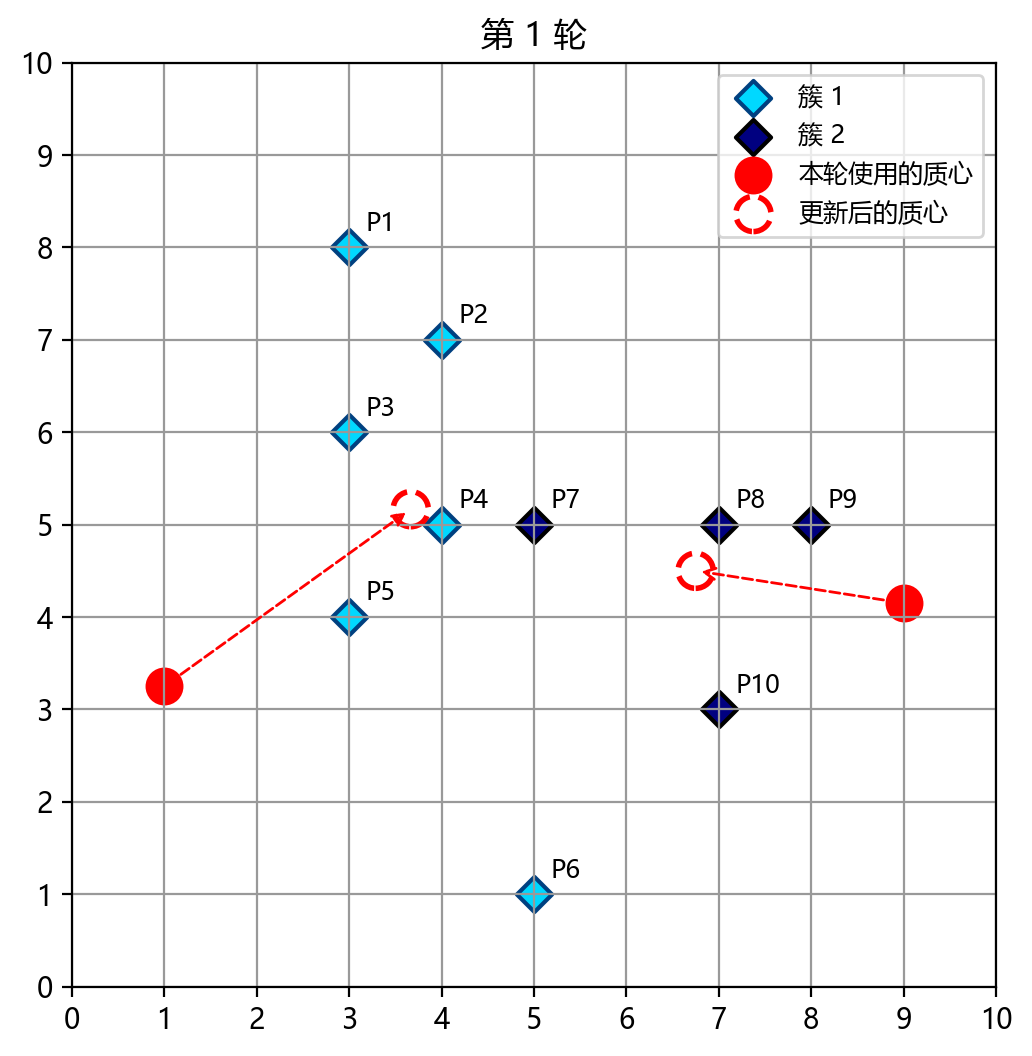
(1) 第 1 轮 :簇 1 = { P 1 , … , P 6 } \{P_1,\dots,P_6\} { P 1 , … , P 6 } { P 7 , … , P 10 } \{P_7,\dots,P_{10}\} { P 7 , … , P 10 } m 1 = ( 3 + 4 + 3 + 4 + 3 + 5 6 , 8 + 7 + 6 + 5 + 4 + 1 6 ) ≈ ( 3.67 , 5.17 ) , m 2 = ( 5 + 7 + 8 + 7 4 , 5 + 5 + 5 + 3 4 ) = ( 6.75 , 4.5 ) m_1=\left(\frac{3+4+3+4+3+5}{6},\ \frac{8+7+6+5+4+1}{6}\right)\approx(3.67,\ 5.17),\qquad m_2=\left(\frac{5+7+8+7}{4},\ \frac{5+5+5+3}{4}\right)=(6.75,\ 4.5) m 1 = ( 6 3 + 4 + 3 + 4 + 3 + 5 , 6 8 + 7 + 6 + 5 + 4 + 1 ) ≈ ( 3.67 , 5.17 ) , m 2 = ( 4 5 + 7 + 8 + 7 , 4 5 + 5 + 5 + 3 ) = ( 6.75 , 4.5 ) E ≈ 41.92 E\approx 41.92 E ≈ 41.92
图9-2(b) k-means 第 1 轮
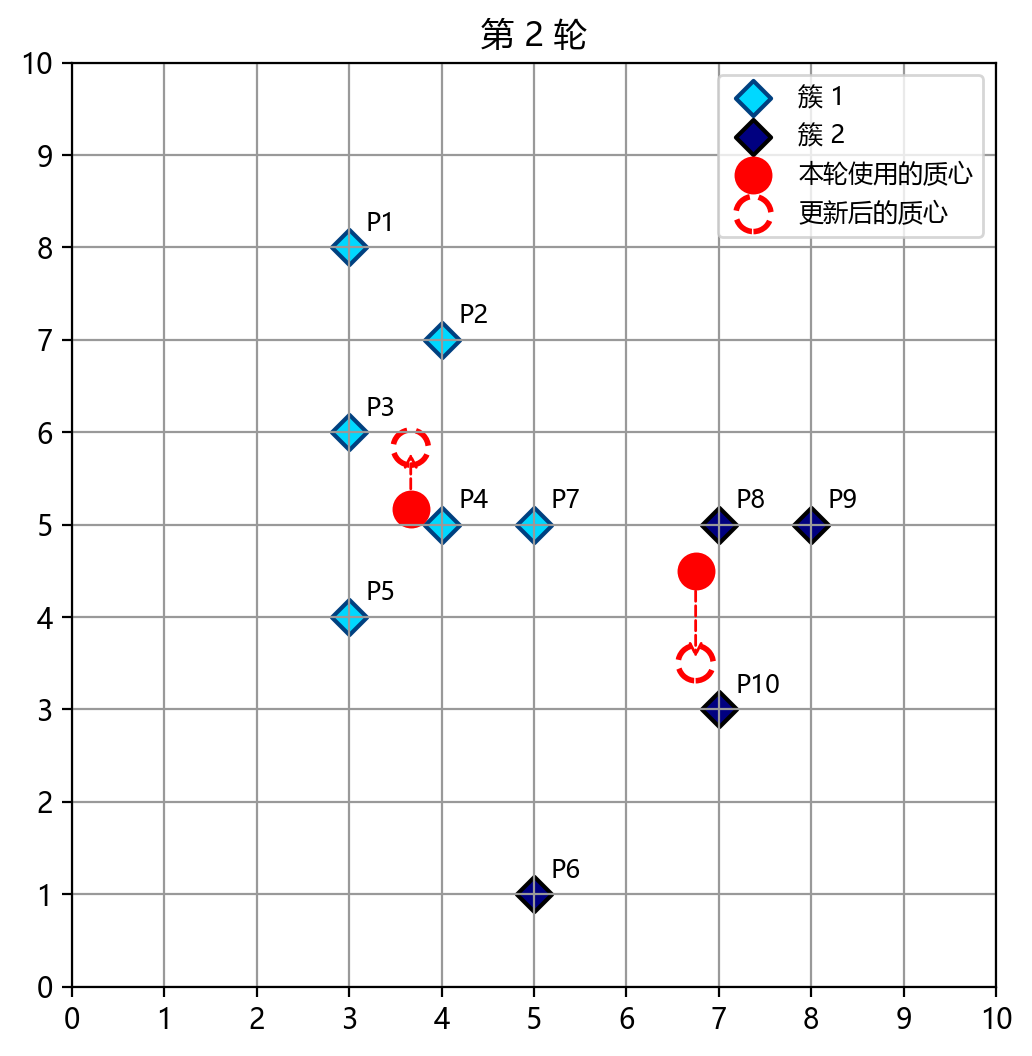
(2) 第 2 轮 :以新质心重新分配,P 6 P_6 P 6 m 2 m_2 m 2 P 7 P_7 P 7 m 1 m_1 m 1 { P 1 , … , P 5 , P 7 } \{P_1,\dots,P_5,P_7\} { P 1 , … , P 5 , P 7 } { P 6 , P 8 , P 9 , P 10 } \{P_6,P_8,P_9,P_{10}\} { P 6 , P 8 , P 9 , P 10 } m 1 = ( 22 6 , 35 6 ) ≈ ( 3.67 , 5.83 ) , m 2 = ( 27 4 , 14 4 ) = ( 6.75 , 3.5 ) m_1=\left(\frac{22}{6},\ \frac{35}{6}\right)\approx(3.67,\ 5.83),\qquad m_2=\left(\frac{27}{4},\ \frac{14}{4}\right)=(6.75,\ 3.5) m 1 = ( 6 22 , 6 35 ) ≈ ( 3.67 , 5.83 ) , m 2 = ( 4 27 , 4 14 ) = ( 6.75 , 3.5 ) E ≈ 29.92 E\approx 29.92 E ≈ 29.92 P 6 P_6 P 6 P 7 P_7 P 7
图9-2(c) k-means 第 2 轮
(3) 第 3 轮 :以新质心再次分配,所有对象的归属均未改变,质心也不再变化,算法收敛。最终聚类结果为:
簇 1:{ ( 3 , 8 ) , ( 4 , 7 ) , ( 3 , 6 ) , ( 4 , 5 ) , ( 3 , 4 ) , ( 5 , 5 ) } \{(3,8),(4,7),(3,6),(4,5),(3,4),(5,5)\} {( 3 , 8 ) , ( 4 , 7 ) , ( 3 , 6 ) , ( 4 , 5 ) , ( 3 , 4 ) , ( 5 , 5 )} ( 3.67 , 5.83 ) (3.67,\,5.83) ( 3.67 , 5.83 )
簇 2:{ ( 5 , 1 ) , ( 7 , 5 ) , ( 8 , 5 ) , ( 7 , 3 ) } \{(5,1),(7,5),(8,5),(7,3)\} {( 5 , 1 ) , ( 7 , 5 ) , ( 8 , 5 ) , ( 7 , 3 )} ( 6.75 , 3.5 ) (6.75,\,3.5) ( 6.75 , 3.5 )
图9-2(d) k-means 第 3 轮
迭代过程中 E E E m 1 m_1 m 1 m 2 m_2 m 2
k-medoids(PAM)算法 针对 k-means 对离群值敏感的问题进行改进:用簇中的实际对象(medoid,中心点)代替质心,目标函数改为最小化绝对误差和:
E = ∑ i = 1 k ∑ p ∈ C i ∣ ∣ p − o i ∣ ∣ (9-25) E = \sum_{i=1}^k \sum_{\mathbf{p} \in C_i} ||\mathbf{p} - \mathbf{o}_i|| \tag{9-25} E = i = 1 ∑ k p ∈ C i ∑ ∣∣ p − o i ∣∣ ( 9-25 ) o i \mathbf{o}_i o i C i C_i C i
2. 层次方法
层次聚类无需预先指定簇的数量,结果以树状图(Dendrogram)形式呈现。
凝聚法(AGNES, Agglomerative Nesting) ——自底向上:
将每个对象视为单独一个簇
计算所有簇对之间的距离
合并距离最近的一对簇
更新距离矩阵
重复步骤 3-4,直到所有对象合并为一个簇或达到指定簇数
不同的簇间距离定义 会产生不同的聚类效果:
表9-32 层次聚类的簇间距离定义
距离指标
定义
特点
最小距离(单链接)
两簇中对象间距离的最小值
对链状分布敏感
最大距离(全链接)
两簇中对象间距离的最大值
倾向产生较紧凑的簇
平均距离
两簇中所有对象对距离的平均值
对孤立点较单链接更稳健
Ward 距离
合并后簇内平方误差的增加量
倾向产生大小较均衡的簇
计算示例 :设 5 个样本在二维空间中的取值如下表所示,采用单连接(最小距离)的凝聚法进行层次聚类。单连接以两簇中最接近的两个对象之间的距离作为簇间距离:
D ( C i , C j ) = min p ∈ C i , q ∈ C j d ( p , q ) (9-26) D(C_i,C_j)=\min_{\mathbf{p}\in C_i,\ \mathbf{q}\in C_j} d(\mathbf{p},\mathbf{q}) \tag{9-26} D ( C i , C j ) = p ∈ C i , q ∈ C j min d ( p , q ) ( 9-26 )
表9-33 层次聚类示例样本的取值
样本
1
2
3
4
5
x 1 x_1 x 1 10
20
30
30
5
x 2 x_2 x 2 5
20
10
15
10
先计算样本两两之间的欧氏距离,得到初始距离矩阵(对称矩阵,只列下三角):
表9-34 样本间的初始距离矩阵
样本
1
2
3
4
5
1 0.00
2 18.0
0.00
3 20.6
14.1
0.00
4 22.4
11.2
5.00
0.00
5 7.07
18.0
25.0
25.5
0.00
(1) 第 1 步 :先将 5 个样本各看作一个簇。最靠近的两个簇是 3 和 4,它们具有最小的簇间距离 D ( 3 , 4 ) = 5.0 D(3,4)=5.0 D ( 3 , 4 ) = 5.0 { 1 } \{1\} { 1 } { 2 } \{2\} { 2 } { 3 , 4 } \{3,4\} { 3 , 4 } { 5 } \{5\} { 5 } D ( 1 , ( 34 ) ) = min { D ( 1 , 3 ) , D ( 1 , 4 ) } = min { 20.6 , 22.4 } = 20.6 D(1,(34))=\min\{D(1,3),D(1,4)\}=\min\{20.6,\,22.4\}=20.6 D ( 1 , ( 34 )) = min { D ( 1 , 3 ) , D ( 1 , 4 )} = min { 20.6 , 22.4 } = 20.6 D ( 2 , ( 34 ) ) = min { D ( 2 , 3 ) , D ( 2 , 4 ) } = min { 14.1 , 11.2 } = 11.2 D(2,(34))=\min\{D(2,3),D(2,4)\}=\min\{14.1,\,11.2\}=11.2 D ( 2 , ( 34 )) = min { D ( 2 , 3 ) , D ( 2 , 4 )} = min { 14.1 , 11.2 } = 11.2 D ( 5 , ( 34 ) ) = min { D ( 5 , 3 ) , D ( 5 , 4 ) } = min { 25.0 , 25.5 } = 25.0 D(5,(34))=\min\{D(5,3),D(5,4)\}=\min\{25.0,\,25.5\}=25.0 D ( 5 , ( 34 )) = min { D ( 5 , 3 ) , D ( 5 , 4 )} = min { 25.0 , 25.5 } = 25.0
其余簇之间的距离不变,得到更新后的矩阵:
表9-35 合并簇{3,4}后的距离矩阵
簇
1
2
(34)
5
1 0.00
2 18.0
0.00
(34) 20.6
11.2
0.00
5 7.07 18.0
25.0
0.00
(2) 第 2 步 :矩阵中最小的距离是 D ( 1 , 5 ) = 7.07 D(1,5)=7.07 D ( 1 , 5 ) = 7.07 { 1 , 5 } \{1,5\} { 1 , 5 } { 2 } \{2\} { 2 } { 3 , 4 } \{3,4\} { 3 , 4 } D ( ( 15 ) , 2 ) = min { D ( 1 , 2 ) , D ( 5 , 2 ) } = min { 18.0 , 18.0 } = 18.0 D((15),2)=\min\{D(1,2),D(5,2)\}=\min\{18.0,\,18.0\}=18.0 D (( 15 ) , 2 ) = min { D ( 1 , 2 ) , D ( 5 , 2 )} = min { 18.0 , 18.0 } = 18.0 D ( ( 15 ) , ( 34 ) ) = min { D ( 1 , ( 34 ) ) , D ( 5 , ( 34 ) ) } = min { 20.6 , 25.0 } = 20.6 D((15),(34))=\min\{D(1,(34)),D(5,(34))\}=\min\{20.6,\,25.0\}=20.6 D (( 15 ) , ( 34 )) = min { D ( 1 , ( 34 )) , D ( 5 , ( 34 ))} = min { 20.6 , 25.0 } = 20.6
表9-36 合并簇{1,5}后的距离矩阵
簇
(15)
2
(34)
(15) 0.00
2 18.0
0.00
(34) 20.6
11.2 0.00
(3) 第 3 步 :最小距离是 D ( 2 , ( 34 ) ) = 11.2 D(2,(34))=11.2 D ( 2 , ( 34 )) = 11.2 { 3 , 4 } \{3,4\} { 3 , 4 } { 1 , 5 } \{1,5\} { 1 , 5 } { 2 , 3 , 4 } \{2,3,4\} { 2 , 3 , 4 } D ( ( 15 ) , ( 234 ) ) = min { D ( ( 15 ) , 2 ) , D ( ( 15 ) , ( 34 ) ) } = min { 18.0 , 20.6 } = 18.0 D((15),(234))=\min\{D((15),2),D((15),(34))\}=\min\{18.0,\,20.6\}=18.0 D (( 15 ) , ( 234 )) = min { D (( 15 ) , 2 ) , D (( 15 ) , ( 34 ))} = min { 18.0 , 20.6 } = 18.0
(4) 第 4 步 :只剩下两个簇,其距离为 18.0,将它们合并为包含全部 5 个样本的一个簇,算法结束。整个过程汇总如下:
表9-37 凝聚聚类的合并过程汇总
步骤
合并的簇
合并距离
合并后的簇集合
1
{ 3 } \{3\} { 3 } { 4 } \{4\} { 4 } 5.0
{ 1 } \{1\} { 1 } { 2 } \{2\} { 2 } { 3 , 4 } \{3,4\} { 3 , 4 } { 5 } \{5\} { 5 }
2
{ 1 } \{1\} { 1 } { 5 } \{5\} { 5 } 7.07
{ 1 , 5 } \{1,5\} { 1 , 5 } { 2 } \{2\} { 2 } { 3 , 4 } \{3,4\} { 3 , 4 }
3
{ 2 } \{2\} { 2 } { 3 , 4 } \{3,4\} { 3 , 4 } 11.2
{ 1 , 5 } \{1,5\} { 1 , 5 } { 2 , 3 , 4 } \{2,3,4\} { 2 , 3 , 4 }
4
{ 1 , 5 } \{1,5\} { 1 , 5 } { 2 , 3 , 4 } \{2,3,4\} { 2 , 3 , 4 } 18.0
{ 1 , 2 , 3 , 4 , 5 } \{1,2,3,4,5\} { 1 , 2 , 3 , 4 , 5 }
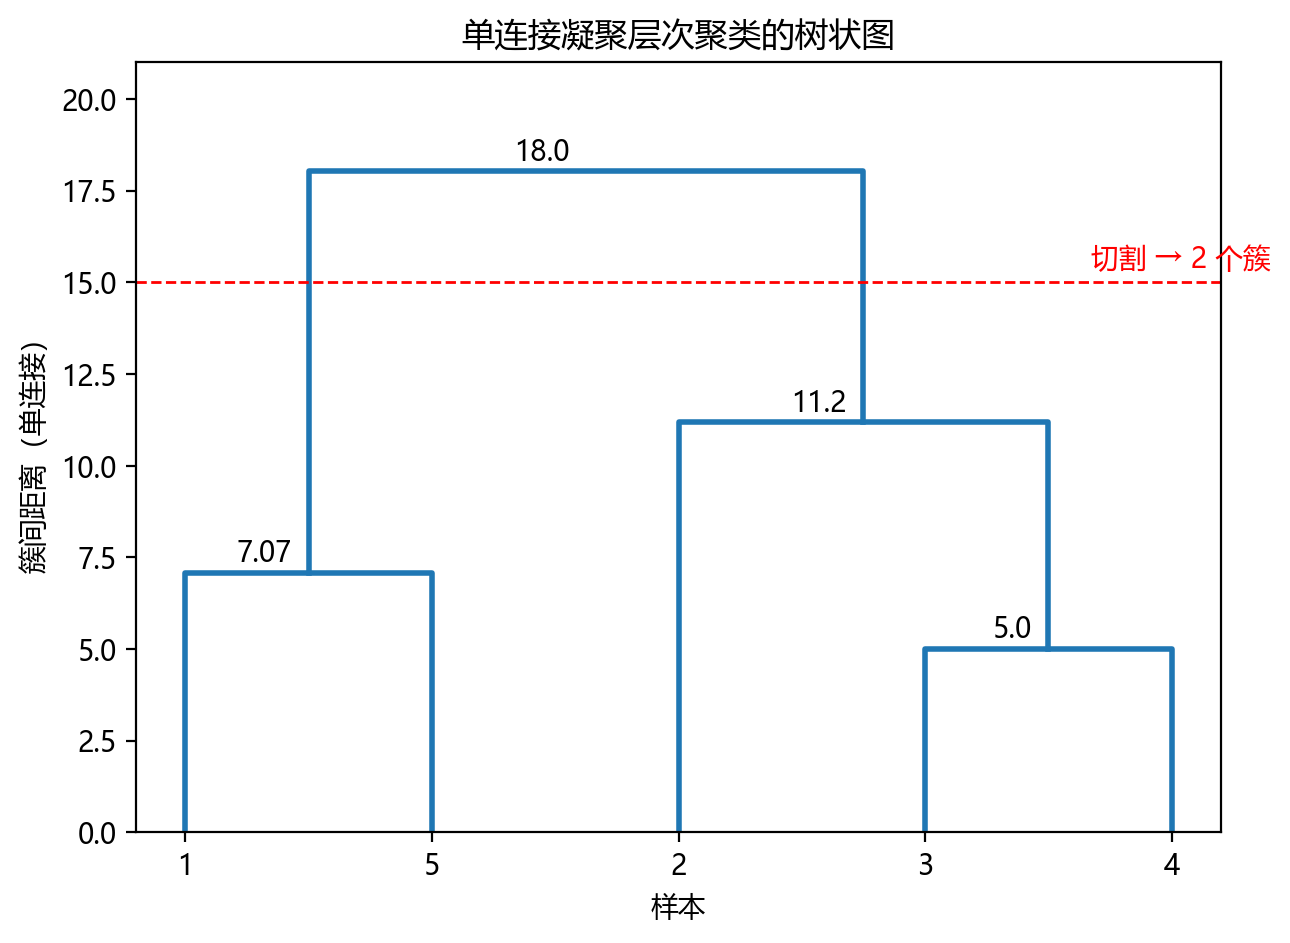
将上述合并过程按合并距离为纵坐标画出,就得到图9-3 所示的树状图。在指定的高度水平切割树状图,即可得到相应数目的簇:例如在距离 15 处切割,与水平线相交的竖线有 2 条,得到 { 1 , 5 } \{1,5\} { 1 , 5 } { 2 , 3 , 4 } \{2,3,4\} { 2 , 3 , 4 } { 1 } \{1\} { 1 } { 2 } \{2\} { 2 } { 3 , 4 } \{3,4\} { 3 , 4 } { 5 } \{5\} { 5 }
图9-3 单连接凝聚层次聚类的树状图
分裂法(DIANA, Divisive Analysis) ——自顶向下:
与凝聚法方向相反,分裂法从所有对象属于同一个簇开始,逐步将簇分裂为更小的子簇。
算法步骤 :
将所有对象置于一个初始簇中
在当前所有簇中,选择直径最大 的簇 C C C
在 C C C 平均不相似度最大 的对象 p ∗ \mathbf{p}^* p ∗ C n e w C_{new} C n e w C o l d C_{old} C o l d p ∗ = arg max p ∈ C 1 ∣ C ∣ − 1 ∑ q ∈ C , q ≠ p d ( p , q ) (9-27) \mathbf{p}^* = \arg\max_{\mathbf{p} \in C} \frac{1}{|C|-1} \sum_{\mathbf{q} \in C, \mathbf{q} \neq \mathbf{p}} d(\mathbf{p}, \mathbf{q}) \tag{9-27} p ∗ = arg p ∈ C max ∣ C ∣ − 1 1 q ∈ C , q = p ∑ d ( p , q ) ( 9-27 )
对 C o l d C_{old} C o l d q \mathbf{q} q C n e w C_{new} C n e w d n e w ( q ) d_{new}(\mathbf{q}) d n e w ( q ) C o l d C_{old} C o l d d o l d ( q ) d_{old}(\mathbf{q}) d o l d ( q ) d n e w ( q ) < d o l d ( q ) d_{new}(\mathbf{q}) < d_{old}(\mathbf{q}) d n e w ( q ) < d o l d ( q ) q \mathbf{q} q C o l d C_{old} C o l d C n e w C_{new} C n e w
重复步骤 4 直到无对象需要移动,完成一次分裂
重复步骤 2-5,直到每个簇只包含一个对象或达到指定簇数
表9-38 凝聚法与分裂法的对比
特性
凝聚法(AGNES)
分裂法(DIANA)
方向
自底向上(合并)
自顶向下(分裂)
初始状态
每个对象一个簇
所有对象一个簇
决策方式
选择最相似的簇对合并
选择最不紧凑的簇分裂
全局视角
较弱,每次仅考虑局部最优合并
较强,每次分裂利用簇内全局信息
纠错能力
早期的错误合并无法撤销
早期的错误分裂无法撤销
时间复杂度
O ( n 2 log n ) O(n^2 \log n) O ( n 2 log n ) O ( 2 n ) O(2^n) O ( 2 n ) O ( n 2 ) O(n^2) O ( n 2 )
适用性 :凝聚法在实际中更为常用,因为分裂法每次需要考虑簇的所有可能二分方式,计算代价较高。但分裂法具有更好的全局视角——它在初始阶段就能利用所有数据点的信息做出分裂决策,因此在簇的层次结构顶层(大簇拆分)时往往比凝聚法更准确。在实践中,二者可以结合使用:先用分裂法获取粗粒度的簇结构,再在每个子簇内用凝聚法细化。
BIRCH 算法 利用 CF 树(聚类特征树)实现了对大规模数据的增量层次聚类,是层次聚类在大数据场景下的代表性改进。
3. 基于密度的方法
DBSCAN 算法(Density-Based Spatial Clustering of Applications with Noise) 通过识别由低密度区域分隔的高密度区域来发现任意形状的簇。
核心概念 :
ε \varepsilon ε p \mathbf{p} p ε \varepsilon ε N ε ( p ) = { q ∈ D ∣ d ( p , q ) ≤ ε } N_\varepsilon(\mathbf{p}) = \{\mathbf{q} \in D \mid d(\mathbf{p}, \mathbf{q}) \leq \varepsilon\} N ε ( p ) = { q ∈ D ∣ d ( p , q ) ≤ ε } 核心对象 :若 ∣ N ε ( p ) ∣ ≥ M i n P t s |N_\varepsilon(\mathbf{p})| \geq MinPts ∣ N ε ( p ) ∣ ≥ M in P t s p \mathbf{p} p 直接密度可达 :若 q ∈ N ε ( p ) \mathbf{q} \in N_\varepsilon(\mathbf{p}) q ∈ N ε ( p ) p \mathbf{p} p q \mathbf{q} q p \mathbf{p} p 密度可达 :存在对象链 p 1 , p 2 , … , p n \mathbf{p}_1, \mathbf{p}_2, \ldots, \mathbf{p}_n p 1 , p 2 , … , p n p i + 1 \mathbf{p}_{i+1} p i + 1 p i \mathbf{p}_i p i 密度相连 :存在对象 o \mathbf{o} o p \mathbf{p} p q \mathbf{q} q o \mathbf{o} o
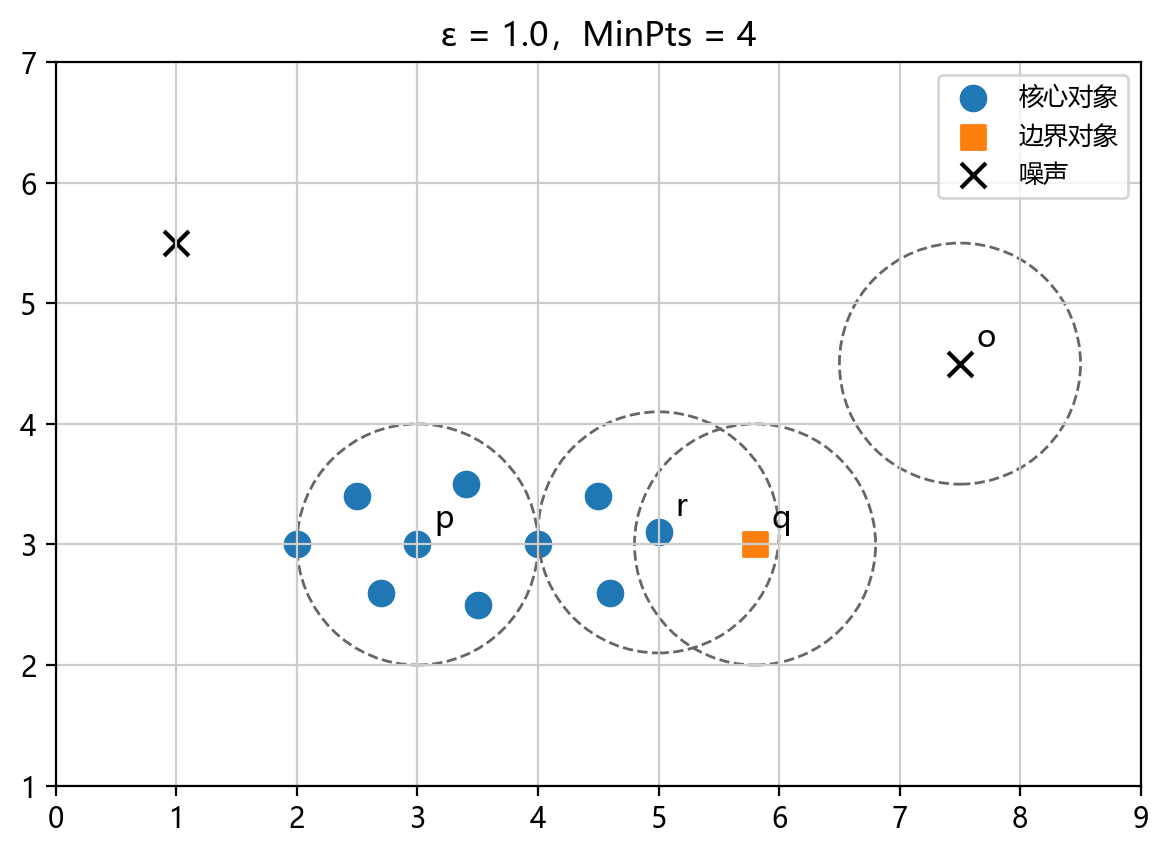
图9-4(a)以 ε = 1 \varepsilon=1 ε = 1 M i n P t s = 4 MinPts=4 M in P t s = 4 p p p ε \varepsilon ε q q q r r r M i n P t s MinPts M in P t s o o o q q q p p p
图9-4(a) 核心对象、边界对象与噪声
算法步骤 :
对数据集中每个未访问的对象 p \mathbf{p} p ε \varepsilon ε
若 ∣ N ε ( p ) ∣ ≥ M i n P t s |N_\varepsilon(\mathbf{p})| \geq MinPts ∣ N ε ( p ) ∣ ≥ M in P t s p \mathbf{p} p
若 ∣ N ε ( p ) ∣ < M i n P t s |N_\varepsilon(\mathbf{p})| < MinPts ∣ N ε ( p ) ∣ < M in P t s p \mathbf{p} p
重复直到所有对象被处理
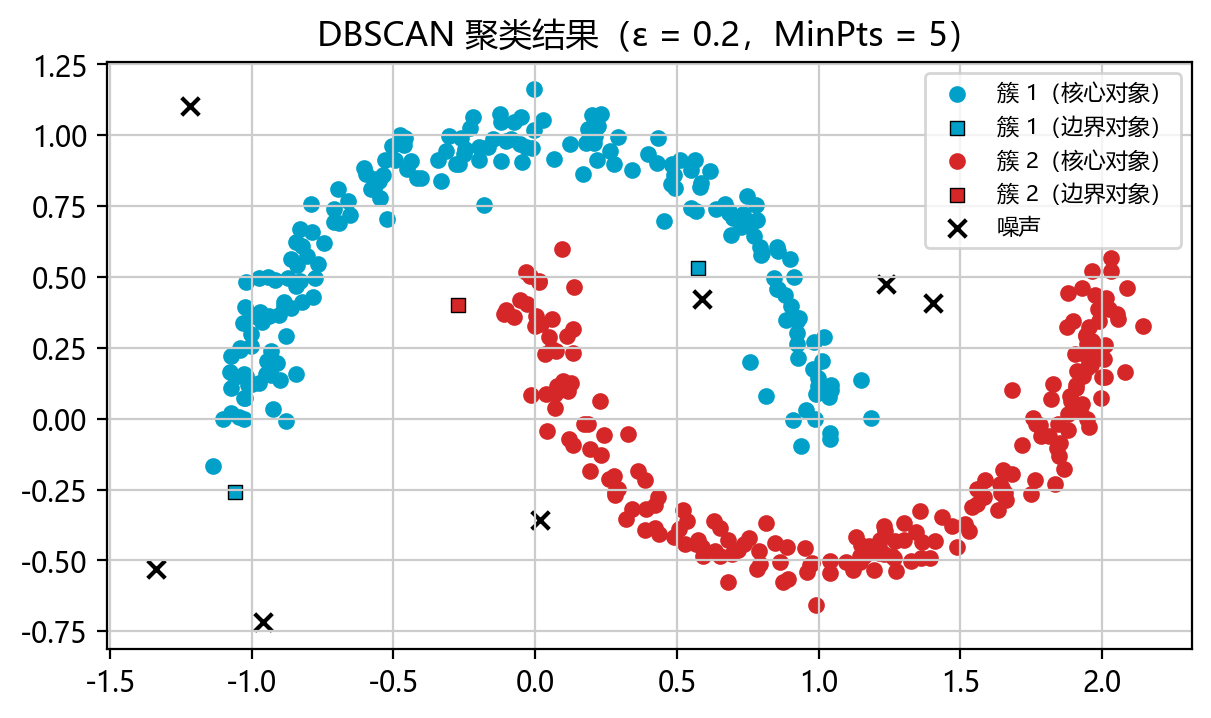
图9-4(b)展示了 DBSCAN 在带有离群点的双月形数据上的聚类结果:算法从核心对象出发,不断扩展密度可达的对象,最终得到两个形状弯曲的簇,位于稀疏区域的离群点被标记为噪声。这类形状是 k-means 难以正确划分的。
图9-4(b) DBSCAN 对双月形数据的聚类结果
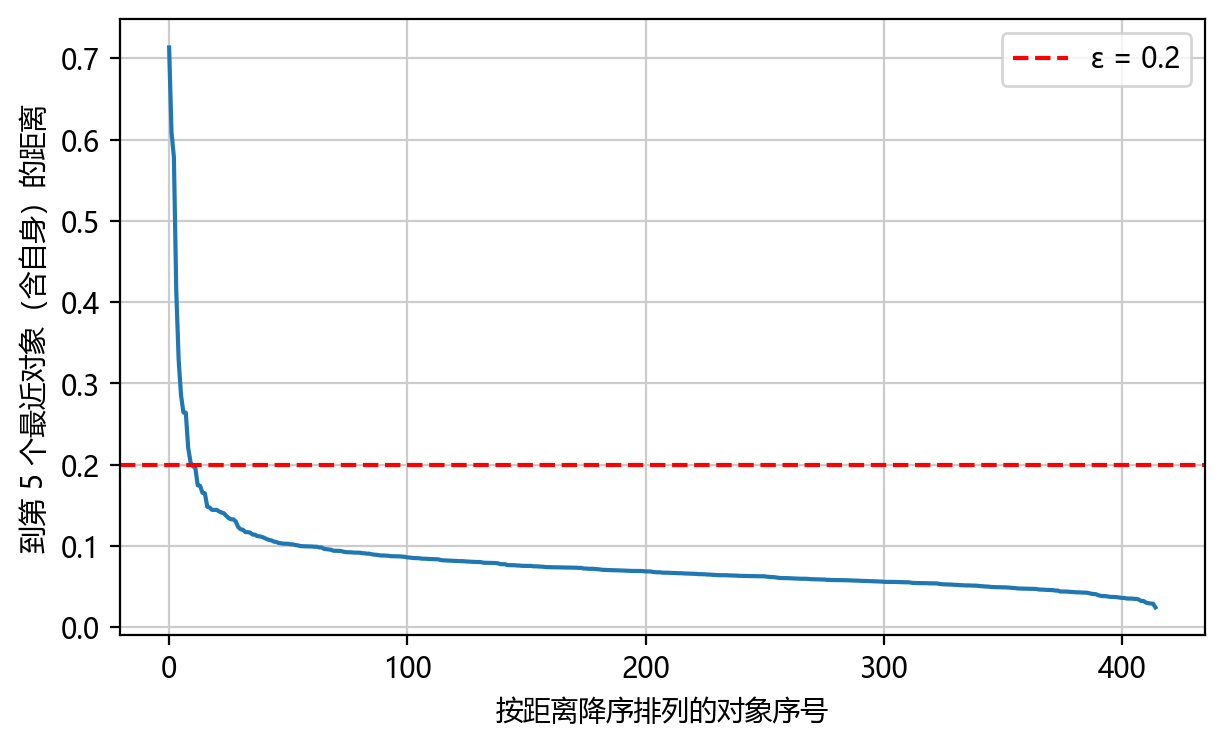
参数选择 :DBSCAN 需要事先给定 ε \varepsilon ε M i n P t s MinPts M in P t s M i n P t s MinPts M in P t s ε \varepsilon ε
确定 M i n P t s MinPts M in P t s :经验上取数据维数 n n n M i n P t s = 2 n MinPts = 2n M in P t s = 2 n M i n P t s = 5 MinPts=5 M in P t s = 5 计算 k-距离 :令 k = M i n P t s k=MinPts k = M in P t s k k k ε \varepsilon ε ε \varepsilon ε M i n P t s MinPts M in P t s 绘制 k-距离图 :将所有对象的 k-距离从大到小排序并作图,如图9-4(c)所示。选取拐点 :曲线左端是少数 k-距离很大的对象,它们处于稀疏区域,对应离群点;其后曲线迅速变得平缓,对应簇内较为密集的对象。取拐点处的 k-距离作为 ε \varepsilon ε ε = 0.2 \varepsilon=0.2 ε = 0.2
图9-4(c) k-距离图
适用性 :DBSCAN 能发现任意形状的簇且无需预设簇数,自动识别噪声点。但对不同密度的簇效果较差,对高维数据因"维度灾难"效果下降,且对 ε \varepsilon ε M i n P t s MinPts M in P t s
4. CHAMELEON聚类
上述聚类算法——无论是 k-means、AGNES 还是 DBSCAN——在合并或划分簇时,都依赖于某种静态模型 (如固定的距离度量、全局密度阈值等)。当数据集中存在形状、大小和密度差异显著的簇时,静态模型往往力不从心。CHAMELEON(Clustering Using Dynamic Modeling) 算法由 Karypis、Han 和 Kumar 于 1999 年提出,它通过动态建模 克服了这一根本性局限。
核心思想 :CHAMELEON 在合并两个簇时,不仅考察它们之间的绝对相似性,还将其与两个簇各自的内部特征进行对比。只有当两个簇之间的相对互连性 和相对紧密性 都足够高时,才执行合并。这种"因簇制宜"的动态策略使得 CHAMELEON 能够自动适应不同簇的内在特征,发现其他算法无法正确识别的自然聚类。
算法框架(两阶段) :
第一阶段:构造 k k k
将数据集建模为 k k k G k G_k G k p \mathbf{p} p q \mathbf{q} q k k k p \mathbf{p} p q \mathbf{q} q
使用图分割算法 (如 hMETIS)对 G k G_k G k
第二阶段:基于动态模型的凝聚合并
定义两个核心度量来衡量簇对 ( C i , C j ) (C_i, C_j) ( C i , C j )
① 相对互连性(Relative Inter-connectivity, RI)
R I ( C i , C j ) = ∣ E C { C i , C j } ∣ ∣ E C C i ∣ + ∣ E C C j ∣ 2 (9-28) RI(C_i, C_j) = \frac{|EC_{\{C_i, C_j\}}|}{\frac{|EC_{C_i}| + |EC_{C_j}|}{2}} \tag{9-28} R I ( C i , C j ) = 2 ∣ E C C i ∣ + ∣ E C C j ∣ ∣ E C { C i , C j } ∣ ( 9-28 ) 其中:
E C { C i , C j } EC_{\{C_i, C_j\}} E C { C i , C j } C i C_i C i C j C_j C j C i ∪ C j C_i \cup C_j C i ∪ C j C i C_i C i C j C_j C j E C C i EC_{C_i} E C C i C i C_i C i 最小割二分 的边切割值(将 C i C_i C i 分母取两个簇内部互连性的平均值,起到归一化作用
含义 :R I RI R I 相对于 两个簇各自内部连接强度的比值。R I RI R I
② 相对紧密性(Relative Closeness, RC)
R C ( C i , C j ) = S ˉ E C { C i , C j } ∣ C i ∣ ∣ C i ∣ + ∣ C j ∣ S ˉ E C C i + ∣ C j ∣ ∣ C i ∣ + ∣ C j ∣ S ˉ E C C j (9-29) RC(C_i, C_j) = \frac{\bar{S}_{EC_{\{C_i, C_j\}}}}{\frac{|C_i|}{|C_i|+|C_j|} \bar{S}_{EC_{C_i}} + \frac{|C_j|}{|C_i|+|C_j|} \bar{S}_{EC_{C_j}}} \tag{9-29} R C ( C i , C j ) = ∣ C i ∣ + ∣ C j ∣ ∣ C i ∣ S ˉ E C C i + ∣ C i ∣ + ∣ C j ∣ ∣ C j ∣ S ˉ E C C j S ˉ E C { C i , C j } ( 9-29 ) 其中:
S ˉ E C { C i , C j } \bar{S}_{EC_{\{C_i, C_j\}}} S ˉ E C { C i , C j } C i C_i C i C j C_j C j 平均权重 S ˉ E C C i \bar{S}_{EC_{C_i}} S ˉ E C C i S ˉ E C C j \bar{S}_{EC_{C_j}} S ˉ E C C j C i C_i C i C j C_j C j 平均权重 分母对两个簇的内部紧密性按簇大小做加权平均
含义 :R C RC R C 相对于 两个簇各自内部的紧密程度。R C RC R C
合并决策 :CHAMELEON 选择使以下组合函数最大化的簇对进行合并:
S c o r e ( C i , C j ) = R I ( C i , C j ) × R C ( C i , C j ) α (9-30) Score(C_i, C_j) = RI(C_i, C_j) \times RC(C_i, C_j)^\alpha \tag{9-30} S cor e ( C i , C j ) = R I ( C i , C j ) × R C ( C i , C j ) α ( 9-30 ) α \alpha α α > 1 \alpha > 1 α > 1 α < 1 \alpha < 1 α < 1
算法复杂度 :CHAMELEON 的总体时间复杂度为 O ( n m + n log n + m 2 log m ) O(nm + n\log n + m^2 \log m) O ( nm + n log n + m 2 log m ) n n n m m m
适用性与优势 :
CHAMELEON 能发现形状、大小和密度各异 的自然聚类,这是 k-means(仅适合球形簇)、CURE(忽略簇间互连性)和 DBSCAN(依赖全局密度参数)所不具备的能力。
动态建模使得合并决策能自动适应不同簇的内在特征,无需用户提供静态的相似性模型。
基于 k k k
局限性 :算法性能依赖于 k k k α \alpha α k k k O ( n 2 ) O(n^2) O ( n 2 )
9.7 异常点分析
9.7.1 异常点的定义与价值
异常点是在数据分布或局部密度上显著偏离大多数对象的样本。传统统计分析常将其视为噪声予以剔除,但在欺诈检测、入侵监测、设备故障诊断和医疗异常识别等应用中,异常点往往具有重要价值。
9.7.2 异常检测方法
异常检测方法依据所采用的假设,可分为基于统计分布、基于距离和基于局部密度三类。
1. 基于统计分布的方法
假设数据遵循某种概率模型(如高斯分布),将处于低概率区域的对象判定为异常点。
参数化方法 :对于一维数据,假设服从正态分布 N ( μ , σ 2 ) N(\mu, \sigma^2) N ( μ , σ 2 ) 3 σ 3\sigma 3 σ x x x ∣ x − μ ∣ > 3 σ |x - \mu| > 3\sigma ∣ x − μ ∣ > 3 σ
对于多维数据,可使用马氏距离(Mahalanobis Distance) :
D M ( x ) = ( x − μ ) T Σ − 1 ( x − μ ) (9-31) D_M(\mathbf{x}) = \sqrt{(\mathbf{x} - \boldsymbol{\mu})^T \Sigma^{-1} (\mathbf{x} - \boldsymbol{\mu})} \tag{9-31} D M ( x ) = ( x − μ ) T Σ − 1 ( x − μ ) ( 9-31 ) μ \boldsymbol{\mu} μ Σ \Sigma Σ D M ( x ) D_M(\mathbf{x}) D M ( x ) χ n , α 2 \chi^2_{n,\alpha} χ n , α 2
适用性 :适用于数据分布已知且近似满足假设的场景。但对多维数据或复杂分布的建模能力有限,且参数化假设在现实数据中往往难以满足。
2. 基于距离的方法
无需假设数据分布,通过计算对象间的距离来判定异常。
DB(p c t pct p c t d m i n d_{min} d min :数据集 D D D o \mathbf{o} o D B ( p c t , d m i n ) DB(pct, d_{min}) D B ( p c t , d min ) p c t pct p c t o \mathbf{o} o d m i n d_{min} d min ∣ { q ∈ D ∣ d ( o , q ) > d m i n } ∣ ∣ D ∣ ≥ p c t (9-32) \frac{|\{\mathbf{q} \in D \mid d(\mathbf{o}, \mathbf{q}) > d_{min}\}|}{|D|} \geq pct \tag{9-32} ∣ D ∣ ∣ { q ∈ D ∣ d ( o , q ) > d min } ∣ ≥ p c t ( 9-32 )
等价地说,对象 o \mathbf{o} o d m i n d_{min} d min ( 1 − p c t ) × ∣ D ∣ (1 - pct) \times |D| ( 1 − p c t ) × ∣ D ∣
k-最近邻(kNN)异常检测 :计算每个对象到其第 k k k d k ( o ) d_k(\mathbf{o}) d k ( o ) d k ( o ) d_k(\mathbf{o}) d k ( o ) n n n
适用性 :基于距离的方法简单直观,不需要数据分布假设。但时间复杂度较高(朴素实现为 O ( n 2 ) O(n^2) O ( n 2 )
3. 基于局部密度的LOF方法
局部离群因子(Local Outlier Factor, LOF) 通过比较对象与其邻居的局部密度识别异常点,能够处理不同密度区域中的局部异常。
计算步骤 :
① 第 k k k :对象 p \mathbf{p} p k k k d k ( p ) d_k(\mathbf{p}) d k ( p ) p \mathbf{p} p k k k
② 可达距离(Reachability Distance) :
r e a c h - d i s t k ( p , o ) = max { d k ( o ) , d ( p , o ) } (9-33) reach\text{-}dist_k(\mathbf{p}, \mathbf{o}) = \max\{d_k(\mathbf{o}), d(\mathbf{p}, \mathbf{o})\} \tag{9-33} r e a c h - d i s t k ( p , o ) = max { d k ( o ) , d ( p , o )} ( 9-33 )
③ 局部可达密度(Local Reachability Density) :
l r d k ( p ) = 1 1 ∣ N k ( p ) ∣ ∑ o ∈ N k ( p ) r e a c h - d i s t k ( p , o ) (9-34) lrd_k(\mathbf{p}) = \frac{1}{\frac{1}{|N_k(\mathbf{p})|} \sum_{\mathbf{o} \in N_k(\mathbf{p})} reach\text{-}dist_k(\mathbf{p}, \mathbf{o})} \tag{9-34} l r d k ( p ) = ∣ N k ( p ) ∣ 1 ∑ o ∈ N k ( p ) r e a c h - d i s t k ( p , o ) 1 ( 9-34 ) p \mathbf{p} p k k k p \mathbf{p} p
④ 局部离群因子 :
L O F k ( p ) = 1 ∣ N k ( p ) ∣ ∑ o ∈ N k ( p ) l r d k ( o ) l r d k ( p ) (9-35) LOF_k(\mathbf{p}) = \frac{1}{|N_k(\mathbf{p})|} \sum_{\mathbf{o} \in N_k(\mathbf{p})} \frac{lrd_k(\mathbf{o})}{lrd_k(\mathbf{p})} \tag{9-35} L O F k ( p ) = ∣ N k ( p ) ∣ 1 o ∈ N k ( p ) ∑ l r d k ( p ) l r d k ( o ) ( 9-35 )
LOF 值的含义:
L O F ≈ 1 LOF \approx 1 L O F ≈ 1 L O F ≫ 1 LOF \gg 1 L O F ≫ 1 L O F < 1 LOF < 1 L O F < 1
适用性 :LOF 能有效识别不同密度区域中的局部异常点,这是纯距离方法无法做到的。参数 k k k k ∈ [ 10 , 50 ] k \in [10, 50] k ∈ [ 10 , 50 ] O ( n 2 ) O(n^2) O ( n 2 )
9.8 数据挖掘应用
9.8.1 典型应用领域
数据挖掘已在多个领域形成成熟应用。金融领域利用分类和异常检测评估贷款信用风险,通过关联分析识别可疑交易;生物信息学领域对基因表达数据进行聚类和模式发现;互联网应用中,链接分析、推荐系统和点击流分析依赖大规模数据挖掘技术。
不同应用的数据对象和任务重点不同。金融应用关注风险控制和欺诈识别,生物信息学应用关注序列、网络和高维表达数据,互联网应用关注链接结构、用户行为和实时反馈。数据挖掘方法在这些领域通常需要结合业务规则进行结果解释和部署。
9.8.2 复杂类型数据挖掘
除关系数据和事务数据外,图数据、文本数据、时间序列、空间数据和流数据也推动了专门挖掘方法的发展。图挖掘利用频繁子图、社区发现和链接预测分析社交网络与生物网络;文本挖掘结合自然语言处理技术完成分词、向量表示、主题建模和情感分析;流数据挖掘则强调增量更新和有限内存下的近似处理。
9.8.3 数据挖掘与隐私保护
数据挖掘在提升决策能力的同时,也带来个人信息保护、算法公平性和结果可解释性等问题。匿名化处理难以完全防止个体身份重识别,差分隐私通过加入受控噪声为统计查询提供可量化的隐私保护。实际应用应在数据利用价值与个人信息权益之间建立明确边界,并通过技术手段、制度和审计机制共同约束。
本章小结
数据挖掘是在大规模数据中发现隐含、未知且有潜在价值知识的过程,通常作为知识发现流程中的核心环节。按照任务目标,数据挖掘包括特征描述、关联分析、分类、预测、聚类、异常点分析和演化分析等类型。原始数据往往存在缺失、噪声、不一致和尺度差异,清洗、集成、变换和归约分别解决数据质量问题、多源数据合并、表示形式调整和规模压缩,预处理质量直接影响挖掘结果。
分类问题利用信息论工具度量不确定性:信息熵刻画随机变量的不确定性,条件熵表示给定特征后的剩余不确定性,信息增益和信息增益比用于选择能有效降低类别不确定性的特征。决策树将特征选择与递归划分相结合,ID3、C4.5和CART分别采用信息增益、信息增益比和基尼指数,在连续属性处理、缺失值处理和剪枝策略上各有不同。关联规则挖掘以支持度、置信度和提升度评价规则质量,Apriori和FP-growth分别通过候选项集剪枝和频繁模式树压缩事务数据。
聚类和异常点分析均属于无监督任务。聚类通过相似性度量将对象划分为若干簇,k-means使用质心迭代优化,层次聚类通过合并或分裂形成层次结构,DBSCAN根据局部密度识别任意形状的簇。异常检测可基于统计分布、距离或局部密度,局部离群因子方法能够处理不同密度区域中的异常点。数据挖掘已广泛应用于金融、生物信息学、互联网和工业领域,并在数据价值利用与隐私保护之间提出新的技术与治理要求。
课后习题
原始数据中常见的质量问题有哪些?数据清洗、数据集成、数据变换和数据归约分别解决什么问题?
设属性 年龄 的取值范围为 20 至 80,某样本值为 35。使用最小-最大规范化将属性映射到区间 [ 0 , 1 ] [0,1] [ 0 , 1 ]
说明信息熵和条件熵的含义。为什么信息增益能够作为分类问题中的特征选择准则?
解释信息增益比相对于信息增益的改进原因。为什么 C4.5 通常先筛选信息增益高于平均水平的特征,再选择信息增益比最高的特征?
设事务数据库包含 100 条事务,其中 20 条同时包含 A 和 B,25 条包含 A,40 条包含 B。计算关联规则 A→B 的支持度、置信度和提升度,并解释提升度的含义。
分别说明 k-means、层次聚类和 DBSCAN 的主要思想、适用条件和局限性。
在聚类分析中,为什么通常需要先对数值属性进行规范化?举例说明不同属性量纲对距离计算的影响。
结合一个实际应用场景,说明数据挖掘结果如何用于决策。
参考文献
[1] Jiawei Han, Micheline Kamber. Data Mining: Concepts and Techniques[M]. 2nd ed. San Francisco: Morgan Kaufmann, 2006.
[2] 李航. 统计学习方法(第2版)[M]. 北京:清华大学出版社,2019.
[3] J. Ross Quinlan. C4.5: Programs for Machine Learning[M]. San Mateo: Morgan Kaufmann, 1993.
[4] Leo Breiman, Jerome Friedman, Richard Olshen, Charles Stone. Classification and Regression Trees[M]. New York: Chapman and Hall/CRC, 1984.
[5] Pang-Ning Tan, Michael Steinbach, Vipin Kumar. Introduction to Data Mining[M]. Boston: Pearson, 2006.
[6] Jiawei Han, Micheline Kamber, Jian Pei. Data Mining: Concepts and Techniques[M]. 3rd ed. Waltham: Morgan Kaufmann, 2012.
[7] Scikit-learn Developers. Clustering[EB/OL]. https://scikit-learn.org/stable/modules/clustering.html.