第4章 计算机网络
学习目标
- 理解计算机网络、互联网、网络边缘与网络核心等基本概念。
- 掌握协议分层思想,熟悉 OSI 参考模型、TCP/IP 模型。
- 掌握 IPv4、IPv6、子网划分和路由选择的基本原理。
- 理解 HTTP、DNS、电子邮件等典型网络服务的工作机制。
- 掌握对称加密、非对称加密、数字签名等网络安全基础。
引言
计算机网络是现代物流信息系统运行的基础。仓储管理、运输监控、电子数据交换、订单跟踪和供应链协同等业务,都需要在端系统之间可靠地传输数据。本章以互联网为主线,系统介绍计算机网络体系结构、网络寻址、典型应用协议和网络安全基础。首先从硬件构成、组织管理和服务提供三个视角认识互联网,讲解协议的三要素、电路交换与分组交换的区别,以及常见的接入方式与网络拓扑,并以 TCP/IP 五层模型为主线阐明分层体系结构。接着介绍网络寻址体系,包括 IPv4 与 IPv6 地址结构、子网划分与 CIDR、NAT 技术、DHCP 协议和路由原理,说明数据如何从发送端经过接入网、网络核心到达目的端。然后围绕 HTTP 协议的工作流程、请求与响应报文、Cookies、Web 缓存,以及 DNS、电子邮件系统、内容分发网络等典型网络服务,讲解其工作机制与协议交互过程。最后介绍网络安全基础,包括常见安全威胁、密码学基本原理、数字签名与认证中心、HTTPS 和防火墙、VPN 等网络安全实务。通过本章学习,读者可以理解物流信息系统运行的网络环境,掌握数据传输与网络服务的基本原理,为后续技术章节的学习奠定基础。
4.1 互联网概述
互联网也叫因特网(Internet),是当今世界规模最大、覆盖范围最广的计算机互联网络。它并非某一个单独的网络,而是由全球大量异构网络(包括企业网、校园网、数据中心网络、移动运营商网络等)通过统一的 TCP/IP 协议族 互联而形成的“网络的网络”(Network of Networks)。截至 2025 年,全球已有超过 50 亿用户和数百亿台设备接入互联网,应用范围覆盖个人通信、电子商务、工业控制和智慧物流等领域。
4.1.1 三种理解视角
理解互联网可以从硬件构成、组织管理和服务提供三个视角出发:
1. 硬件构成视角
从物理组成来看,因特网由以下核心组件构成:
(1)端系统(End System),也称主机(Host):位于网络边缘的所有计算设备。传统上指台式计算机和服务器,如今已扩展至智能手机、平板电脑、智能传感器、车载终端、工业 PLC 等一切具备网络通信能力的设备。端系统是网络中数据的最终发送者与接收者。 (2)通信链路(Communication Link):连接各网络设备的物理传输介质。常见类型包括双绞铜线(用于以太网布线)、同轴电缆、光导纤维(光纤)以及无线电波(WiFi、蜂窝移动通信)。每种链路具有不同的传输速率(即带宽,单位为 bps——比特每秒)和传输特性。例如,单模光纤的传输距离可达数十公里且带宽极高,而双绞线虽成本低廉但传输距离和抗干扰能力有限。 (3)分组交换设备:负责在网络核心中转发数据的中间设备,主要包括路由器(Router)和链路层交换机(Link-layer Switch)。路由器工作在网络层,根据 IP 地址进行跨网络的路径选择与数据转发;链路层交换机工作在数据链路层,根据 MAC 地址在同一局域网内实现帧的交换与投递。
2. 组织管理视角
从组织管理来看,因特网并非由单一机构统一运营,而是由众多独立运营、通过统一协议互联互通的管理主体共同构成,体现出分布式治理特征:
(1)因特网服务提供商(ISP, Internet Service Provider):端系统并不直接相互连接,而是通过各级 ISP 接入因特网。ISP 本身也是由分组交换设备和通信链路构成的网络,是提供接入、传输和路由服务的运营实体。ISP 之间存在层级关系:本地 ISP(如校园网运营方、社区宽带运营商)连接到区域 ISP,区域 ISP 再连接到全国或全球性的一级 ISP(Tier-1 ISP,如 AT&T、中国电信骨干网)。各级 ISP 之间通过**对等连接(Peering)或转接(Transit)**协议高效互联,形成了因特网的层次化拓扑结构。 (2)自治系统(AS, Autonomous System):自治系统是指在单一管理机构下运行统一路由策略的 IP 网络的集合,是因特网路由管理的基本单元。每个自治系统被分配一个全球唯一的自治系统号(ASN, Autonomous System Number),用于在互联网中标识。自治系统可以是一个 ISP、一所大学、一家企业,甚至一个城市或国家级骨干网。自治系统内部的路由由内部网关协议(如 OSPF、RIP)管理,而自治系统之间的路由则由外部网关协议(BGP)协调,从而实现互联网的分层路由与管理。例如,中国电信(ASN 4134)、中国移动(ASN 9808)各自构成一个自治系统,它们之间通过 BGP 协议交换路由信息。 (3)互联网交换点(IXP, Internet Exchange Point):多个 ISP 或自治系统在物理上汇聚、交换流量的场所,使不同网络运营商之间可以直接互联而无须绕行第三方网络,从而降低时延、节省成本。 (4)国际标准化与协调机构:互联网的正常运行还依赖一系列国际协调组织,如负责域名和 IP 地址分配管理的 **ICANN(互联网名称与数字地址分配机构)**及其下属的区域性互联网注册机构(如面向亚太地区的 APNIC),负责制定互联网技术标准的 IETF(互联网工程任务组),负责万维网技术标准的 **W3C(万维网联盟)**等。这些机构通过技术标准、地址资源分配和政策协调,保障了全球互联网在“去中心化运营”前提下的互联互通与统一有序。
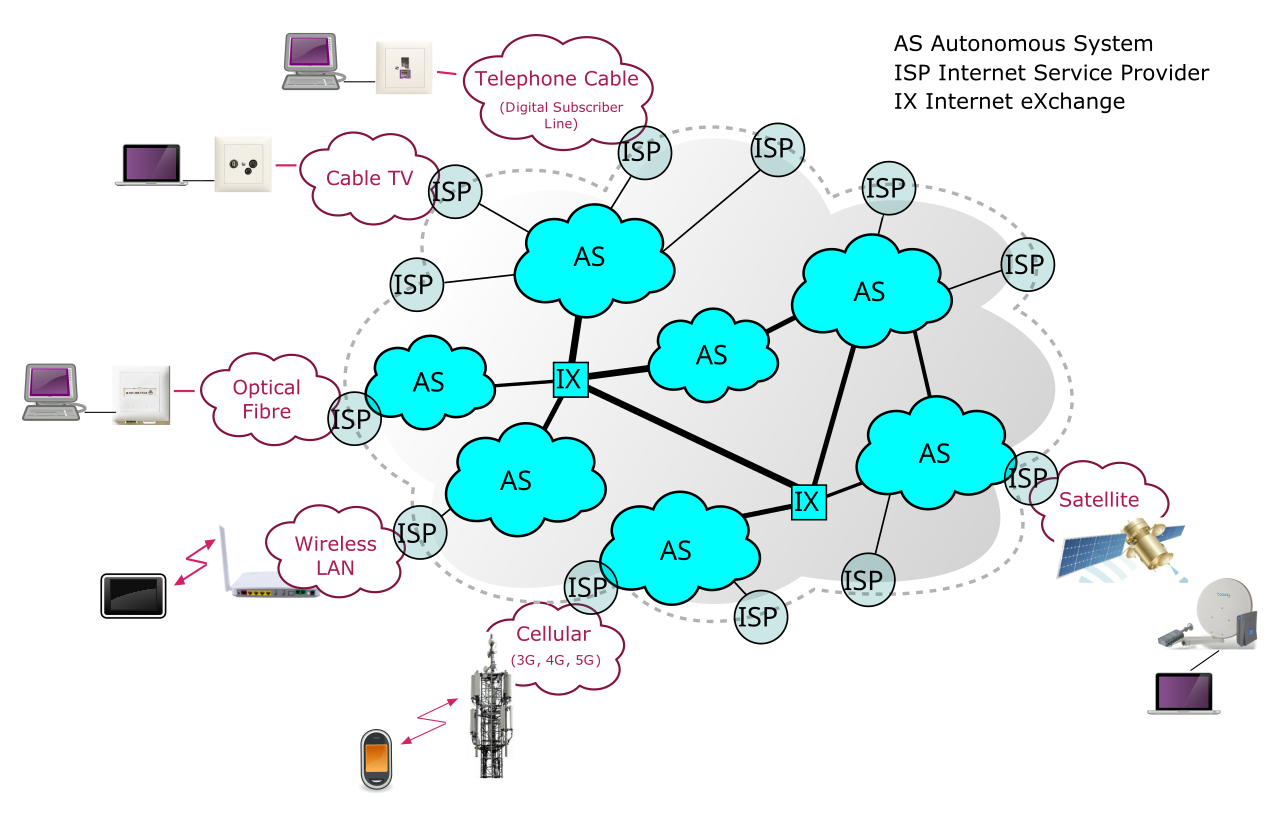
图4-1 互联网总体结构示意图
由此可见,组织管理视角强调的是:因特网在物理上和运营上高度分散、由无数自治的管理主体各自负责本地网络,但通过统一的地址体系、路由协议和标准规范实现全局协同,这正是因特网“自治而互联”的治理精髓。
3. 服务提供视角
从功能角度来看,因特网是一个为分布式应用程序(Distributed Applications)提供通信服务的基础设施平台。电子邮件、万维网浏览、即时通信、视频流媒体、在线地图、物流追踪系统等应用程序运行在端系统上,它们之间需要相互交换数据。因特网为这些应用提供了两类核心传输服务:
(1)面向连接的可靠传输服务(TCP):保证数据完整、有序地送达目的端,适用于文件传输、网页加载等对数据完整性要求严格的场景。 (2)无连接的尽力而为传输服务(UDP):不保证可靠送达,但时延低、开销小,适用于实时音视频通信、在线游戏等对时效性要求高于完整性的场景。
应用程序通过操作系统提供的套接字接口(Socket API) 来调用这些传输服务。套接字是应用层与传输层之间的编程接口——应用开发者只需将数据交给套接字,底层的数据封装、路由寻址、差错控制等复杂工作均由协议栈自动完成。
4.1.2 网络通信协议
协议(Protocol) 是计算机网络中最核心的概念之一。它严格定义了两个或多个通信实体之间进行数据交换时所必须遵守的规则集合,具体包括:
(1)语法(Syntax):规定报文(Message)的格式与结构,即数据的排列方式。例如,一个 IP 数据报的前 4 位表示版本号,接下来 4 位表示首部长度。 (2)语义(Semantics):规定各字段的含义以及通信实体在特定条件下应采取的动作。例如,收到一个 TCP SYN 报文意味着对方请求建立连接,本端应回复 SYN-ACK。 (3)时序(Timing):规定事件的执行顺序和速率约束。例如,TCP 三次握手要求必须先发送 SYN,再收到 SYN-ACK,最后发送 ACK,三个步骤缺一不可。
因特网是一个由大量协议共同协作的系统。不同层次、不同功能都有对应的协议:IP 协议负责寻址与转发,TCP 协议负责可靠传输,HTTP 协议负责网页数据的请求与响应,DNS 协议负责域名解析,等等。理解协议的分层组织与协作关系,是掌握计算机网络的关键。
4.1.3 数据交换方式
在通信网络中,数据从源端传送到目的端需要经过若干中间节点。按照中间节点转发数据的方式不同,可分为两种基本交换方式:
1. 电路交换
电路交换源自传统电话网络。在通信开始之前,网络会在发送方与接收方之间建立一条专用的端到端通信电路,该电路在整个通信过程中被独占使用。电路交换的资源分配方式有两种:**频分复用(FDM)**将链路的频带划分为若干频段,每个连接独占一个频段;**时分复用(TDM)**将时间划分为等长的帧,每帧再分为若干时隙,每个连接在每帧中占用固定时隙。
电路交换的优势在于通信质量有保障(带宽恒定、延迟稳定),但其致命缺陷在于资源利用率低下——即使通信双方暂时无数据发送,所占用的电路资源也无法被其他用户使用。
2. 分组交换
因特网采用分组交换技术。其核心思想是:发送端将应用层数据划分为较小的数据块,每个数据块附加上包含目的地址、序号等控制信息的首部(Header),形成一个个分组(Packet)。分组在网络中以**存储-转发(Store-and-Forward)**的方式传输——每台路由器必须接收到一个完整的分组后,才将其从输出链路转发出去。
分组交换的关键特征是统计复用(Statistical Multiplexing):多个数据流共享同一条链路,链路带宽按需动态分配,而非预先划分。这意味着:
- 当网络负载较轻时,单个用户可以获得接近链路全部带宽的传输速率;
- 当多个用户同时发送数据时,它们的分组在路由器的输出缓冲区中排队等候转发。
正是这种按需共享机制使得分组交换的资源利用率远高于电路交换。但也正因此,分组交换会引入排队时延(Queuing Delay),当流量突发超过缓冲区容量时还会出现丢包(Packet Loss)——这些是分组交换网络必须面对的固有问题。
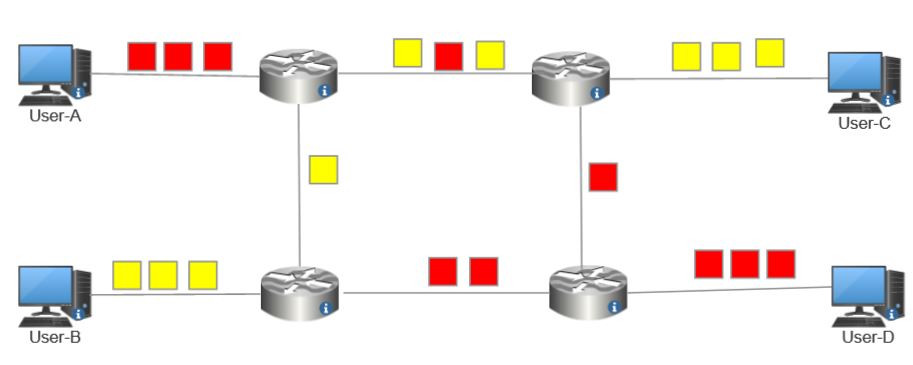
图4-2 分组交换的基本原理
4.1.4 接入方式
1. 接入方式
接入网是将端系统连接到其边缘路由器(Edge Router)的网络。常见的接入网技术包括:
- 数字用户线(DSL, Digital Subscriber Line):利用已有的电话铜线传输数据。用户端的 DSL 调制解调器将数字信号转换为高频模拟信号,在电话局端的 **DSLAM(数字用户线接入复用器)**上再还原为数字信号并接入因特网。DSL 采用频分复用,将铜线带宽划分为三个不重叠的频段:下行高速数据通道、上行数据通道和传统电话通道,因此上网与通话可以同时进行。
- 混合光纤同轴电缆(HFC, Hybrid Fiber Coax):利用有线电视网络基础设施。从头端(Head End)到光纤节点采用光纤传输,从光纤节点到用户家庭采用同轴电缆。HFC 的特点是下行带宽在同一条电缆上被所有用户共享,因此在用户密集的区域,高峰时段的实际速率可能低于标称值。
- 光纤到户(FTTH, Fiber To The Home):从电信局端直接铺设光纤到每户家庭,提供对称或非对称的千兆乃至万兆接入速率。FTTH 有两种主要架构——有源光网络采用有源交换机进行信号再生,无源光网络则使用无源光分路器在光域中完成信号分配,后者因运维成本低而得到广泛部署。
- 无线局域网接入(WiFi):基于 IEEE 802.11 标准的无线接入方式,端系统通过无线电波连接到接入点(AP, Access Point),AP 再通过有线链路连接到因特网。
- 蜂窝移动接入(4G/5G):端系统通过移动运营商的基站接入因特网。5G(第五代移动通信)在速率、时延和连接密度三个维度上实现了显著提升,支持 eMBB(增强型移动宽带)、URLLC(超可靠低时延通信)和 mMTC(大规模机器类通信)三大应用场景。
2. 物理媒介
传输数据的物理媒介可分为两大类:
- 导引型媒介(Guided Media):信号沿固体介质传播。包括双绞铜线(分为非屏蔽双绞线 UTP 和屏蔽双绞线 STP)、同轴电缆以及光纤。光纤是目前传输性能最优异的导引型媒介:传输速率高(单根光纤可承载数十 Tbps)、传输距离远、不受电磁干扰、且窃听困难。
- 非导引型媒介(Unguided Media):信号在自由空间中以电磁波形式传播。包括地面微波、WiFi 无线电、卫星通信和蜂窝通信所使用的各频段无线电波。非导引型媒介无需铺设物理线缆,部署灵活,但易受环境干扰(多径衰落、障碍物遮挡等),且信号强度随距离衰减明显。
4.1.5 网络拓扑结构
设备之间的连接方式和布局形态称为网络拓扑结构(Network Topology)。拓扑结构决定了网络的性能、可靠性、扩展能力和建设成本,是网络规划与设计中首先需要考虑的问题。
根据描述的角度不同,网络拓扑可分为物理拓扑(设备和线缆的实际布局)和逻辑拓扑(数据在网络中的传输路径)。两者不一定一致——例如,一个物理上呈星型连接的以太网,在逻辑上可能以广播方式工作。以下介绍几种最基本的拓扑结构。
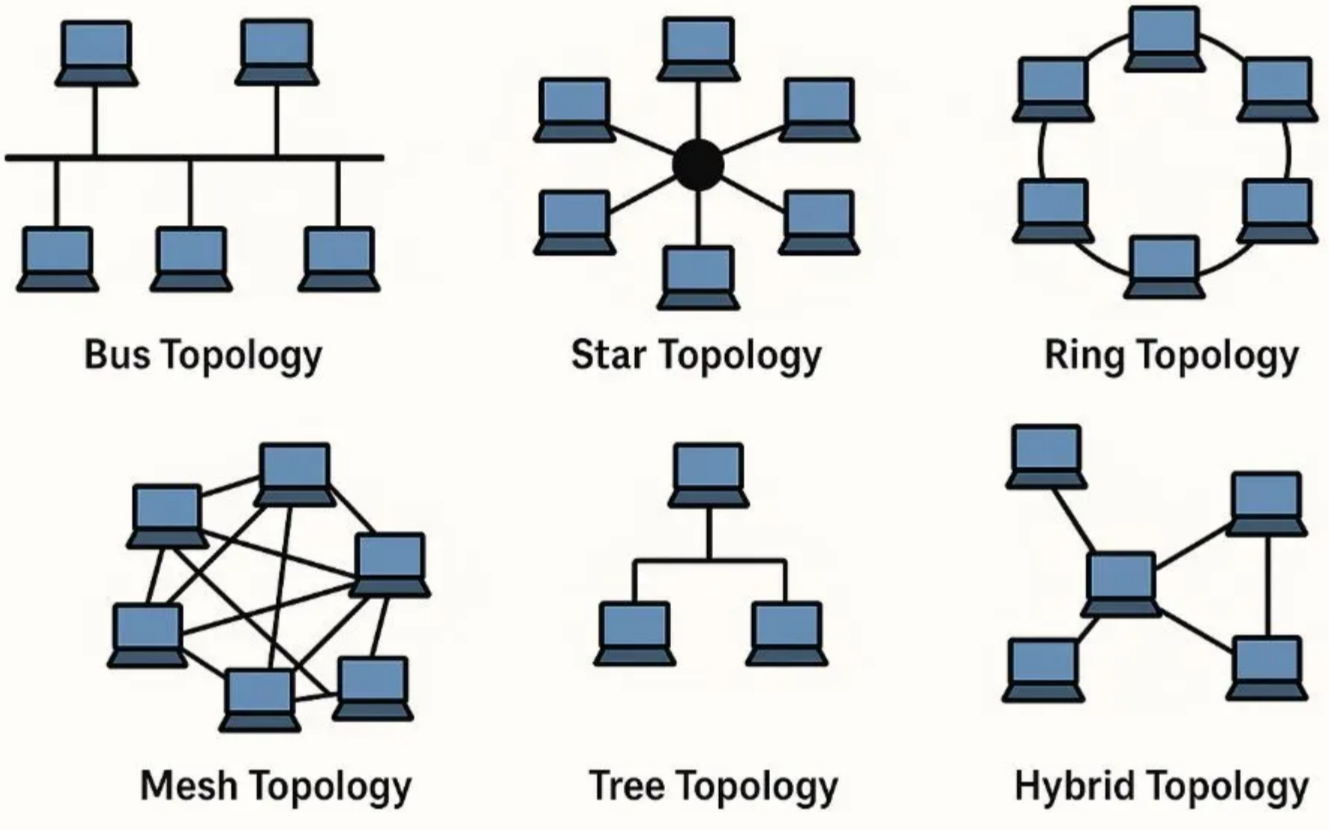
图4-3 网络拓扑结构
1. 总线型拓扑
总线型拓扑中,所有节点共享一条称为"总线"的公共传输通道。每个节点通过一个接口(如 T 型连接器)挂接在总线上。数据信号沿总线向两个方向传播,所有节点都能接收到信号,但只有目的地址匹配的节点才会处理该数据。
优点:
- 结构简单、成本低:只需一根主干线缆和少量连接器,安装方便。
- 节省线缆:所有节点共用一条总线,布线量最少。
缺点:
- 可靠性差:总线是全网的"生命线",总线中任何一点发生断裂或短路,整个网络都将中断。
- 冲突问题:同一时刻只能有一个节点发送数据,当多个节点同时发送时会产生冲突(Collision),导致数据损坏,需要重传。
- 扩展性有限:随着节点增多,冲突概率上升,网络性能急剧下降。故障排查也比较困难,因为难以判断断点位置。
应用场景: 早期的以太网(10BASE2、10BASE5)采用总线型拓扑。由于其可靠性和性能上的固有缺陷,总线型拓扑在现代网络中已很少使用,但在工业控制总线(如 CAN 总线)中仍有应用。
2. 星型拓扑
星型拓扑是当前局域网中最常见的拓扑结构。所有节点(计算机、打印机等终端设备)都通过独立的点对点链路连接到一台中心节点(通常是交换机或集线器),节点之间不直接相连,所有通信都必须经过中心节点中转。
优点:
- 易于管理和故障排查:某一条链路或某一台终端出现故障,只影响该终端自身,不会波及其他节点,网络管理员可以迅速定位问题。
- 易于扩展:新增节点只需将其连接到中心设备的空闲端口即可,无需改动现有布线。
- 性能较好:每个终端独占一条到中心设备的链路,不存在与其他节点争用同一物理信道的问题(使用交换机时)。
缺点:
- 中心节点是单点故障(Single Point of Failure):一旦中心交换机发生故障,整个网络将瘫痪。因此,关键场景下通常会部署冗余中心设备。
- 布线成本较高:每个节点都需要独立的线缆连接到中心设备,当节点数量多且分布分散时,线缆用量和布线复杂度都较大。
应用场景: 绝大多数办公室网络、校园网的楼宇内部网络、物流分拣中心的扫码终端网络等都采用星型拓扑。
3. 环型拓扑
环型拓扑中,每个节点恰好与相邻的两个节点相连,所有节点首尾相连形成一个封闭的环路。数据沿环路单向(或双向)逐站传递,每个节点接收上游节点发来的数据,判断是否是发给自己的——如果是,则接收处理;如果不是,则将数据再生放大后转发给下游节点。
优点:
- 数据传输有序:环上采用令牌传递等访问控制机制,避免了总线型中的冲突问题。
- 传输延迟可预测:数据经过的节点数和路径是确定的。
缺点:
- 可靠性问题:环上任何一个节点或一段链路发生故障,如果不采用冗余措施,整个环路将断裂,全网瘫痪。
- 扩展不便:增加或移除节点时需要断开环路,影响正常通信。
改进方案: 为了提高可靠性,实际部署中常采用双环结构——一条主环承载正常通信,一条备用环在主环故障时自动接管。光纤分布式数据接口(FDDI)和部分城域网采用的就是双环拓扑。
4. 网状型拓扑
网状型拓扑中,每个节点与网络中的其他多个(甚至全部)节点都有直接的点对点链路。如果网络中每对节点之间都有直接链路,则称为全连接网状拓扑(Full Mesh);如果只有部分节点之间存在直接连接,则称为部分连接网状拓扑(Partial Mesh)。
优点:
- 可靠性极高:任何一条链路甚至多条链路同时故障,数据都可以通过其他路径到达目的地。这种冗余特性使得网状拓扑特别适合对可靠性要求极高的骨干网络。
- 通信效率高:两个节点之间可能存在多条路径,路由协议可以选择最优路径,也可以实现负载均衡。
缺点:
- 成本高昂:
个节点的全连接网状网络需要 条链路,当 较大时,设备和布线成本极高。 - 配置管理复杂:大量链路和路由配置增加了运维难度。
应用场景: 因特网的骨干网络(核心路由器之间的连接)、大型物流企业各区域分拣中心之间的网络互联,以及对高可用性有严格要求的金融交易网络,通常采用部分网状拓扑。
5. 树型拓扑
树型拓扑是星型拓扑的层次化扩展。网络中存在一个"根节点"(通常是核心交换机或路由器),向下连接若干"分支节点"(汇聚层交换机),分支节点再向下连接"叶子节点"(接入层交换机或终端设备),形成一种层级分明的树状结构。
优点:
- 层级清晰,便于管理:网络的组织结构与企业或校园的行政层级天然对应,配置和管理十分直观。
- 扩展方便:在某一分支下添加新节点或新的子网,不影响其他分支。
缺点:
- 根节点瓶颈:树根处的设备承载着全网的汇聚流量,一旦故障则全网受影响。
- 层次较深时延迟增加:底层节点之间的通信可能需要经过多级转发。
应用场景: 大型校园网、企业园区网、大型物流仓储中心的网络架构通常采用三层树型拓扑。
6. 混合型拓扑
实际的网络几乎不会采用单一的拓扑结构,而是根据不同区域的功能需求,将多种拓扑混合使用,形成混合型拓扑(Hybrid Topology)。
以一家全国性物流企业的网络为例:总部数据中心内部,服务器之间可能采用网状拓扑,确保高带宽和高可靠性;各区域物流枢纽之间通过运营商的广域网以部分网状拓扑互联,保证枢纽间的多路径冗余;每个仓库内部,扫码终端、称重设备、分拣线控制器等通过交换机以星型拓扑接入本地局域网;而仓库的整体网络则可能采用三层树型拓扑,实现区域隔离和流量汇聚。
下表对常见拓扑结构进行了对比总结:
表4-1 常见网络拓扑结构对比
| 拓扑类型 | 可靠性 | 扩展性 | 成本 | 典型应用场景 |
|---|---|---|---|---|
| 星型 | 中等(依赖中心节点) | 好 | 中等 | 办公室、校园楼宇网络 |
| 总线型 | 低 | 差 | 低 | 早期以太网、工业控制总线 |
| 环型 | 低(单环)/高(双环) | 差 | 中等 | FDDI、城域网 |
| 网状型 | 高 | 中等 | 高 | 骨干网、金融网络 |
| 树型 | 中等(依赖根节点) | 好 | 中等 | 园区网、大型仓储网络 |
| 混合型 | 高 | 好 | 视设计而定 | 实际企业网络 |
4.1.6 协议分层
1. 分层的必要性
因特网的通信过程涉及物理信号传输、差错控制、路由选择、端到端可靠传输、应用数据表示等众多功能。为降低系统复杂性,提升可维护性,网络工程师采用了分层体系结构(Layered Architecture):将整体功能分解为若干层次,每一层只负责一组特定的功能,并通过定义良好的接口向上层提供服务、向下层请求服务。分层的核心价值在于:
- 模块化:各层独立设计与实现,降低了系统复杂度。
- 可替换性:只要接口不变,某一层的实现可以被替换而不影响其他层。例如,将有线以太网替换为 WiFi,只需更改链路层和物理层,上层协议无需修改。
- 标准化:分层为不同厂商的设备和软件提供了统一的互操作框架。
2. OSI参考模型与TCP/IP 模型
国际标准化组织(ISO)提出的 OSI(开放系统互连)参考模型将网络通信划分为七层,自上而下依次为:
- 第 7 层:应用层——为用户应用程序提供网络服务接口。
- 第 6 层:表示层——负责数据格式转换、加密解密、压缩解压。
- 第 5 层:会话层——建立、管理和终止会话连接。
- 第 4 层:传输层——提供端到端的可靠或不可靠数据传输。
- 第 3 层:网络层——负责逻辑寻址与路由选择。
- 第 2 层:数据链路层——负责相邻节点间的帧传输与差错控制。
- 第 1 层:物理层——负责比特流在物理介质上的传输。
OSI 模型具有重要的理论指导意义,但在实际工程中并未被广泛实现。因特网实际采用的是 TCP/IP 体系结构,它将表示层和会话层的功能合并到应用层,形成更精简的五层模型:
- 应用层(Application Layer):定义应用进程之间的通信规则和报文格式。典型协议包括 HTTP(Web)、SMTP(邮件发送)、DNS(域名解析)、FTP(文件传输)等。每个应用层协议都依赖于传输层提供的服务。
- 传输层(Transport Layer):在两台主机的应用进程之间提供端到端的逻辑通信。TCP 提供面向连接的可靠字节流服务(包含流量控制、拥塞控制和按序交付机制);UDP 提供无连接的数据报服务(仅提供基本的复用/分用和差错校验功能)。传输层引入了端口号(Port Number) 的概念,用于区分同一主机上的不同应用进程。
- 网络层(Network Layer):负责将传输层产生的报文段(Segment)封装为数据报(Datagram),并根据目的 IP 地址决定经由哪条路径将其从源主机送达目的主机。核心协议为 IP 协议(定义数据报格式和寻址规则),辅以路由协议(如 OSPF、BGP)动态计算转发路径。
- 数据链路层(Data Link Layer):负责将网络层的数据报封装为帧(Frame),在相邻两个节点之间通过一段链路可靠地传送。典型协议包括以太网(Ethernet)、WiFi(IEEE 802.11)等。链路层使用 MAC 地址(48 位硬件地址)来标识同一链路上的不同设备。
- 物理层(Physical Layer):关注如何在具体的物理介质上传输单个比特。它规定了电气特性(信号电平)、机械特性(接口形状)、功能特性(引脚定义)和过程特性(信号时序),确保"0"和"1"能在线路上被正确表示与识别。
3. 数据封装与解封装
当应用程序发送数据时,数据会自上而下逐层传递,每经过一层,该层会在数据前面(有时后面)添加本层的控制信息(即首部),形成该层的协议数据单元(PDU, Protocol Data Unit)。这一过程称为封装(Encapsulation):
- 应用层产生报文(Message);
- 传输层添加 TCP/UDP 首部,形成报文段(Segment)或用户数据报;
- 网络层添加 IP 首部,形成数据报(Datagram);
- 链路层添加帧头和帧尾,形成帧(Frame);
- 物理层将帧转换为比特流(Bit Stream) 在介质上传输。
接收端则执行相反的解封装(Decapsulation) 过程:自下而上逐层剥去首部,最终将原始数据交付给目的应用程序。这种"逐层封装-逐层解封装"的机制保证了各层协议之间的独立性,每一层只需解读本层的首部信息,而将其余部分视为透明的"载荷"。
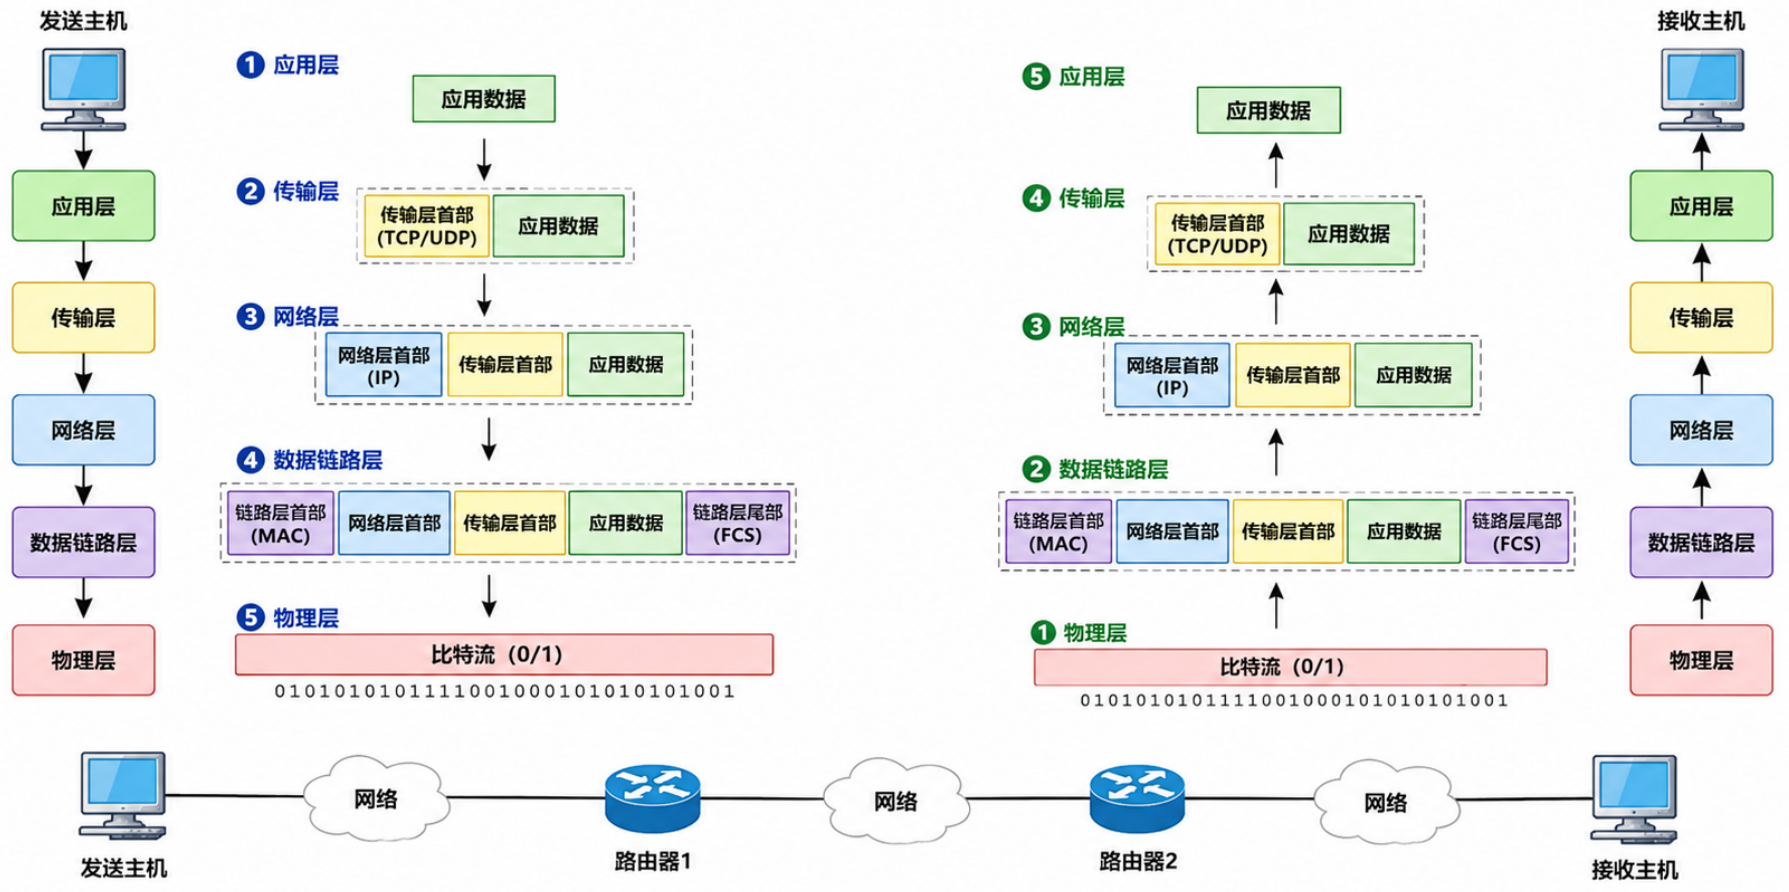
图4-4 TCP/IP 协议栈中的数据封装与解封装过程
4.2 网络寻址
IP 地址是网络层用于标识主机接口的逻辑地址,路由选择负责在网络核心中确定数据报的转发路径。
4.2.1 IP 地址
在因特网中,每一台连接到网络上的设备都需要一个全局可识别的逻辑地址,用于在网络层标识自身并实现跨网络通信,这就是 IP 地址。
1. IPv4 地址
IPv4 地址由 32 位(4 字节) 二进制数组成,为方便人类阅读,通常采用点分十进制(Dotted Decimal Notation) 表示——将 32 位分为 4 组,每组 8 位(1 字节),各组分别转换为 0~255 之间的十进制数,用"."分隔。例如:
对应的点分十进制表示为 192.168.1.100。
传统的分类编址(Classful Addressing)
早期的 IPv4 地址采用分类编址方案,将整个地址空间划分为五类:
表4-2 IPv4 地址分类
| 类别 | 首位模式 | 网络号位数 | 主机号位数 | 地址范围 | 典型用途 |
|---|---|---|---|---|---|
| A 类 | 0 | 8 位 | 24 位 | 1.0.0.0 ~ 126.255.255.255 | 超大型组织(最多约 1677 万台主机) |
| B 类 | 10 | 16 位 | 16 位 | 128.0.0.0 ~ 191.255.255.255 | 大中型组织(最多约 6.5 万台主机) |
| C 类 | 110 | 24 位 | 8 位 | 192.0.0.0 ~ 223.255.255.255 | 小型组织(最多 254 台主机) |
| D 类 | 1110 | — | — | 224.0.0.0 ~ 239.255.255.255 | 多播(组播)地址 |
| E 类 | 1111 | — | — | 240.0.0.0 ~ 255.255.255.255 | 保留,用于实验研究 |
分类编址的问题在于地址分配粒度过粗。例如,一个拥有 300 台主机的组织申请 B 类地址会浪费 6 万多个地址,申请 C 类地址则只有 254 个不够用。正因如此,分类编址已被无类别域间路由(CIDR) 所取代。
特殊 IPv4 地址
以下几类地址在日常使用中经常遇到,需要特别了解:
表4-3 常见 IPv4 特殊用途地址
| 地址/地址块 | 用途说明 |
|---|---|
127.0.0.1 |
环回地址(Loopback),用于主机向自身发送数据进行测试 |
10.0.0.0/8、172.16.0.0/12、192.168.0.0/16 |
私有地址,仅在局域网内部使用,不能直接在因特网上路由 |
0.0.0.0 |
表示"本网络"或"所有接口",常用于服务器监听配置 |
255.255.255.255 |
受限广播地址,向本网络内所有主机发送广播 |
常见的 192.168.x.x 或 10.x.x.x 地址属于私有地址。这些地址由路由器通过 DHCP 自动分配,并配合 NAT 技术共享公网 IP 地址访问互联网。
2. IPv6 地址
32 位的 IPv4 地址空间最多提供约
IPv6 地址采用冒号十六进制(Colon Hexadecimal) 表示法,将 128 位分为 8 组,每组 16 位用 4 个十六进制数字表示,组与组之间用":"分隔。例如:
2001:0db8:85a3:0000:0000:8a2e:0370:7334
为简化书写,IPv6 允许两种压缩规则:
- 每组中的前导零可以省略:
0db8→db8,0000→0。 - 连续的全零组可以用
::替代(每个地址中只能使用一次)。
上述地址可简写为:2001:db8:85a3::8a2e:370:7334。
除了地址空间的扩大,IPv6 还带来了以下改进:
- 简化的报文首部:IPv6 首部固定为 40 字节,取消了 IPv4 中的校验和字段和选项字段,加快了路由器的处理速度。
- 内置的自动配置:IPv6 支持无状态地址自动配置(SLAAC),设备可以根据路由器通告的网络前缀和自身的 MAC 地址自动生成 IPv6 地址,无需 DHCP 服务器。
- 取消 NAT 的需求:充裕的地址空间使得每台设备都可以拥有全球唯一的公网地址,端到端通信无需经过地址转换。
3. IPv4向IPv6的过渡
由于全球已部署的大量 IPv4 设备和基础设施不可能一夜之间全部替换,IPv4 和 IPv6 将在较长时期内共存。目前主要的过渡技术包括:
- 双栈(Dual Stack):设备同时运行 IPv4 和 IPv6 协议栈,根据目的地址选择使用哪种协议。
- 隧道(Tunneling):将 IPv6 数据报封装在 IPv4 数据报的载荷中,穿越只支持 IPv4 的网络区域。
- NAT64/DNS64:在 IPv6 网络与 IPv4 网络的边界进行协议翻译,使纯 IPv6 主机也能访问 IPv4 资源。
4.2.2 子网划分与CIDR
1. 为什么需要子网划分
假设某大学从 ISP 获得了一个 B 类地址块 172.16.0.0,理论上可以容纳 65534 台主机。但如果将所有主机都放在同一个网络中,会产生严重问题:
- 广播风暴:局域网中的广播帧会被发送给网络内的所有主机,6 万多台主机同处一个广播域将导致网络严重拥塞。
- 安全隐患:财务部门的机密数据与学生宿舍的流量处于同一网络,增加了安全风险。
- 管理困难:无法针对不同部门实施差异化的访问控制策略。
子网划分(Subnetting)正是解决这些问题的方法:从主机号中借出若干位作为子网号,将一个大网络切分为多个较小的子网。每个子网是一个独立的广播域,子网之间的通信必须经过路由器——这既隔离了广播流量,又提供了实施访问控制的节点。
2. 子网掩码
子网掩码是一个与 IP 地址等长的 32 位二进制数,用于标明 IP 地址中哪些位属于网络前缀(网络号 + 子网号)、哪些位属于主机号。子网掩码的规则是:网络前缀部分全部置 1,主机号部分全部置 0。
将 IP 地址与子网掩码逐位进行按位与(AND)运算,即可提取出该地址所属的网络地址(子网地址)。
示例: 假设某主机的 IP 地址为 192.168.1.100,子网掩码为 255.255.255.0:
  IP 地址:   11000000.10101000.00000001.01100100  (192.168.1.100)
  子网掩码:  11111111.11111111.11111111.00000000  (255.255.255.0)
  ─────────────────────────────────────────────────
  AND 结果:  11000000.10101000.00000001.00000000  (192.168.1.0)
结果 192.168.1.0 就是该主机所在的子网地址(网络地址)。子网掩码中 1 的位数为 24,因此也可以用 CIDR 表示法写作 192.168.1.0/24,其中 /24 称为前缀长度。
3. 无类别域间路由
CIDR(Classless Inter-Domain Routing,无类别域间路由) 抛弃了 A/B/C 类的固定划分,允许以任意长度的前缀来描述一个 IP 地址块。CIDR 地址的一般形式为:
其中
常见的前缀长度与对应关系如下:
表4-4 CIDR 前缀长度与地址块容量
| CIDR 前缀 | 子网掩码 | 可用主机数 | 说明 |
|---|---|---|---|
| /8 | 255.0.0.0 | 16,777,214 | 相当于旧 A 类网络 |
| /16 | 255.255.0.0 | 65,534 | 相当于旧 B 类网络 |
| /24 | 255.255.255.0 | 254 | 相当于旧 C 类网络 |
| /25 | 255.255.255.128 | 126 | 一个 C 类网络对半分 |
| /26 | 255.255.255.192 | 62 | 一个 C 类网络四等分 |
| /28 | 255.255.255.240 | 14 | 常用于小型服务器网段 |
| /30 | 255.255.255.252 | 2 | 常用于点对点链路(仅两端各一个地址) |
4. 子网划分实例
某物流公司总部获得了地址块 192.168.10.0/24(即 192.168.10.0 ~ 192.168.10.255),需要为以下四个部门划分子网:运营调度中心需要 50 台主机,仓储管理部需要 25 台主机,行政办公室需要 10 台主机,服务器机房需要 5 台主机。
划分步骤:
第一步:确定各子网的前缀长度。 需要选择能容纳所需主机数的最小子网。由于主机号为
- 运营调度中心(50 台):需要
( ),前缀长度 /26。 - 仓储管理部(25 台):需要
( ),前缀长度 /27。 - 行政办公室(10 台):需要
( ),前缀长度 /28。 - 服务器机房(5 台):需要
( ),前缀长度 /29。
第二步:分配子网地址。 这里有两种可行的划分方法:
方法 1:定长子网划分(FLSM, Fixed Length Subnet Mask)
所有子网使用相同的前缀长度。四个部门中最大需求是运营调度中心的 50 台主机,需要 /26(192.168.10.0/24 能划分为 4 个 /26 子网:
表4-5 等长子网划分结果
| 部门 | 子网地址 | 子网掩码 | 可用 IP 范围 | 广播地址 |
|---|---|---|---|---|
| 运营调度中心 | 192.168.10.0/26 | 255.255.255.192 | .1 ~ .62 | .63 |
| 仓储管理部 | 192.168.10.64/26 | 255.255.255.192 | .65 ~ .126 | .127 |
| 行政办公室 | 192.168.10.128/26 | 255.255.255.192 | .129 ~ .190 | .191 |
| 服务器机房 | 192.168.10.192/26 | 255.255.255.192 | .193 ~ .254 | .255 |
FLSM 划分方式简单、掩码统一,但由于每个子网都固定为62个可用主机,行政办公室(需 10 台)和服务器机房(需 5 台)都造成了地址浪费。当各部门需求差异较大时,FLSM的地址利用率较低低。
方法 2:变长子网划分(VLSM, Variable Length Subnet Mask)
VLSM允许各子网使用不同的前缀长度,按从大到小的顺序依次分配,并保证每个子网的起始地址是其大小的整数倍(保持地址对齐):
表4-6 VLSM 子网分配结果
| 部门 | 子网地址 | 子网掩码 | 可用 IP 范围 | 广播地址 |
|---|---|---|---|---|
| 运营调度中心 | 192.168.10.0/26 | 255.255.255.192 | .1 ~ .62 | .63 |
| 仓储管理部 | 192.168.10.64/27 | 255.255.255.224 | .65 ~ .94 | .95 |
| 行政办公室 | 192.168.10.96/28 | 255.255.255.240 | .97 ~ .110 | .111 |
| 服务器机房 | 192.168.10.112/29 | 255.255.255.248 | .113 ~ .118 | .119 |
划分之后,192.168.10.120 ~ 192.168.10.255 的地址仍然空闲,可以留给未来扩展使用。
VLSM按各部门实际需求分配大小合适的子网,地址利用率明显高于FLSM,还剩余了 192.168.10.120/25 这样一整块地址可供未来扩展。但VLSM的规划和管理更复杂,需要仔细计算并保证地址对齐,对网络管理员的要求更高。实际组网中,VLSM是更常用、更节省地址空间的方法。
验证示例: 仓储管理部的某台手持扫码终端 IP 为 192.168.10.78,子网掩码为 255.255.255.224(/27)。执行 AND 运算:
  IP 地址:   11000000.10101000.00001010.01001110  (192.168.10.78)
  子网掩码:  11111111.11111111.11111111.11100000  (255.255.255.224)
  ─────────────────────────────────────────────────
  AND 结果:  11000000.10101000.00001010.01000000  (192.168.10.64)
结果为 192.168.10.64,正是仓储管理部子网的网络地址,说明该终端确实属于仓储管理部子网。
4.2.3 NAT技术
专用网内部的设备通常使用 10.0.0.0/8、172.16.0.0/12 或 192.168.0.0/16 等私有地址。私有地址不能直接在互联网中路由。网络地址转换(Network Address Translation, NAT)用于在专用网与互联网的边界路由器上,将内部私有地址转换为可路由的全球地址。
NAT 路由器至少拥有一个有效的外部全球 IP 地址。专用网主机访问互联网时,NAT 路由器将 IP 数据报中的源地址替换为自身的全球地址,并建立转换表;收到外部应答时,再根据转换表将目的地址还原为对应的私有地址。采用地址和端口转换(Network Address and Port Translation, NAPT)时,转换表还记录传输层端口号,使多台内部主机能够同时共用一个全球 IP 地址。
NAT 在一定程度上缓解了 IPv4 地址不足的问题,但由外部主机主动发起的连接无法直接到达专用网内部主机,因此内部设备通常不能直接作为互联网服务器,除非配置端口映射。NAT 还会使端到端地址发生变化,可能对某些依赖源地址校验的应用产生影响。
4.2.4 DHCP协议
主机接入网络后,至少需要配置 IP 地址、子网掩码、默认网关地址和 DNS 服务器地址。动态主机配置协议(Dynamic Host Configuration Protocol, DHCP)采用客户/服务器方式自动完成上述配置,适用于主机频繁移动的网络。
DHCP 客户端使用 UDP 端口 68,服务器使用 UDP 端口 67。地址分配过程包括四个报文:客户端广播发送 DHCPDISCOVER 发现服务器;服务器用 DHCPOFFER 提供地址和配置参数;客户端选择一个服务器并发送 DHCPREQUEST 请求确认;服务器返回 DHCPACK 后,客户端即可使用所分配的地址。该地址具有租用期,客户端通常在租用期的 50% 和 87.5% 时请求续租,也可以发送 DHCPRELEASE 提前释放。若服务器与客户端不在同一子网,可由 DHCP 中继代理转发报文。
4.2.5 路由原理
路由器的功能可分为路由选择(Routing)和分组转发(Forwarding)。路由选择通过路由协议计算并维护路由表,确定到达目的网络的路径;转发则根据路由表将到达的数据报从合适的接口发送出去。
互联网规模较大,路由协议按自治系统(Autonomous System, AS)分层组织。自治系统内部使用内部网关协议,如基于距离向量的 RIP 和基于链路状态的 OSPF;自治系统之间使用外部网关协议 BGP。转发数据报时,路由器将目的 IP 地址与路由表中的网络前缀逐项匹配,选择匹配前缀最长的表项作为下一跳,即最长前缀匹配。若存在多个匹配项,最长匹配意味着更具体、更准确的路径。
4.3 HTTP协议
20 世纪 90 年代初,蒂姆·伯纳斯-李在 CERN 发明了万维网(World Wide Web),从此因特网走进了千家万户。
4.3.1 C/S架构
Web 应用采用客户机-服务器(C/S)架构。浏览器是客户端(Client),存储网页内容的 Web 服务器(Server)持续运行并等待客户端请求。网页由 HTML 文件、图片、样式表等多个对象(Object) 组成,每个对象具有唯一的 URL(统一资源定位符)。
4.3.2 HTTP协议详解
HTTP(HyperText Transfer Protocol,超文本传输协议) 是万维网的应用层核心协议,定义了浏览器(客户端)与 Web 服务器之间如何进行请求与响应的交互。HTTP 运行在 TCP 协议之上,在发送 HTTP 报文之前,客户端首先与服务器建立一条 TCP 连接,确保数据能够可靠传输。
1. HTTP的基本工作流程
以在浏览器中访问学校教务系统主页 http://jwxt.example.edu.cn/index.html 为例,完整的交互过程如下:
- DNS 解析:浏览器首先向 DNS 服务器查询
jwxt.example.edu.cn对应的 IP 地址(如202.115.32.10)。 - 建立 TCP 连接:浏览器与服务器的 80 端口(HTTP 默认端口)执行 TCP 三次握手,建立可靠连接。
- 发送 HTTP 请求:浏览器通过该连接发送一条 HTTP 请求报文,请求获取
/index.html页面。 - 服务器处理并响应:服务器找到对应资源后,将其封装在 HTTP 响应报文中发回浏览器。
- 浏览器解析并渲染:浏览器解析 HTML 内容,发现其中还引用了 CSS 样式文件、JavaScript 脚本和若干图片,于是再次发起多个 HTTP 请求逐一获取这些对象。
- 关闭或复用连接:所有对象传输完毕后,TCP 连接关闭或被保持以备后续请求复用。
可以看出,打开一个看似简单的网页,浏览器实际上可能需要发送数十甚至上百个 HTTP 请求。
2. HTTP请求报文的结构
HTTP 请求报文由请求行、首部行和实体主体三部分组成。以下是同学登录校园网时,浏览器发出的一个典型请求示例:
GET /index.html HTTP/1.1
Host: jwxt.example.edu.cn
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64)
Accept: text/html, application/xhtml+xml
Accept-Language: zh-CN,zh;q=0.9,en;q=0.8
Connection: keep-alive
- 请求行(第 1 行):包含三个字段——请求方法(
GET)、请求资源的 URL(/index.html)和 HTTP 版本(HTTP/1.1)。 - 首部行(第 2-6 行):以"字段名: 值"的格式携带附加信息。
Host指明目标服务器域名;User-Agent标识浏览器类型和操作系统;Accept声明客户端能接受的内容类型;Connection: keep-alive请求保持 TCP 连接以便发送后续请求。 - 实体主体:GET 请求通常没有实体主体。当使用 POST 方法时(例如同学在教务系统提交登录表单),用户名和密码等数据就会放在实体主体中传送。
3. 常用请求方法
HTTP 定义了多种请求方法,常用的有:
表4-7 常用 HTTP 请求方法
| 方法 | 用途 | 典型场景举例 |
|---|---|---|
| GET | 请求获取指定资源 | 打开网页、加载图片、下载文件 |
| POST | 向服务器提交数据 | 登录账号、提交选课申请、发表评论 |
| PUT | 上传或替换指定资源 | 更新个人信息、上传头像 |
| DELETE | 删除指定资源 | 删除云盘中的文件 |
| HEAD | 仅获取响应首部,不返回实体主体 | 检查文件是否更新、获取文件大小 |
日常网页访问中,GET 和 POST 使用最频繁。浏览页面时使用 GET;提交表单时使用 POST。例如,搜索引擎查询可通过 GET 请求将关键词编码在 URL 查询参数中,而用户登录或发布内容时,表单数据通常放在 POST 请求的实体主体中。
4. HTTP响应报文与状态码
服务器处理请求后返回的 HTTP 响应报文同样由三部分组成:状态行、首部行和实体主体。一个典型的响应如下:
HTTP/1.1 200 OK
Date: Mon, 10 Mar 2026 08:30:00 GMT
Content-Type: text/html; charset=utf-8
Content-Length: 15234
Connection: keep-alive

<!DOCTYPE html>
<html>
  <head><title>教务管理系统</title></head>
  <body>...</body>
</html>
状态行中的 状态码(Status Code) 是服务器对请求结果的简要反馈,由三位数字组成,按首位数字分为五类:
表4-8 HTTP 状态码分类
| 类别 | 含义 | 常见状态码与说明 |
|---|---|---|
| 1xx | 信息性 | 100 Continue——服务器已收到请求头,客户端可以继续发送请求体 |
| 2xx | 成功 | 200 OK——请求成功,资源正常返回 |
| 3xx | 重定向 | 301 Moved Permanently——资源已永久迁移到新 URL;302 Found——临时重定向 |
| 4xx | 客户端错误 | 403 Forbidden——服务器拒绝访问(如权限不足);404 Not Found——请求的资源不存在 |
| 5xx | 服务端错误 | 500 Internal Server Error——服务器内部出错;503 Service Unavailable——服务暂时不可用(如选课系统过载) |
常见状态码包括:请求成功时返回 200 OK;请求资源不存在时返回 404 Not Found;服务器暂时无法提供服务时返回 503 Service Unavailable。
5. 无状态特性与持久连接
HTTP 协议的一个重要特征是无状态(Stateless):服务器不在两次请求之间保存客户端状态,每个请求都独立处理。这一设计简化了服务器实现,使其不必为大量客户端维护会话状态。需要在无状态协议上记录用户状态时,可由 Cookie 等机制实现。
另一个值得关注的概念是 HTTP 的连接管理方式:
- 非持久连接(Non-persistent Connection):HTTP/1.0 的默认方式。每请求一个对象就需要单独建立和关闭一次 TCP 连接。假设一个网页包含 1 个 HTML 文件和 10 张图片,则需要串行建立 11 次 TCP 连接。每次连接都要经历一个 TCP 三次握手过程(约 1 个 RTT 的额外开销),效率较低。
- 持久连接(Persistent Connection):HTTP/1.1 的默认方式。服务器在发送响应后不立即关闭 TCP 连接,后续对同一服务器的请求可以复用该连接。这避免了反复握手的开销,显著降低了页面加载时间。
6. HTTP 版本演进
HTTP 协议经历了多次重要升级:
- HTTP/1.0(1996 年):最早被广泛使用的版本,默认使用非持久连接。
- HTTP/1.1(1997 年):默认启用持久连接,支持管线化(Pipelining)——允许客户端在前一个请求的响应到达之前就发出下一个请求。但管线化在实践中存在**队头阻塞(Head-of-Line Blocking)**问题:如果第一个请求的响应因处理较慢而延迟,后续所有请求的响应都会被阻塞。
- HTTP/2(2015 年):引入了二进制分帧层,将每个 HTTP 报文拆分为更小的帧(Frame),不同请求的帧可以在同一条 TCP 连接上交错传输(Multiplexing),从根本上解决了应用层的队头阻塞问题。同时支持服务器推送(Server Push)——服务器可以主动将客户端可能需要的资源(如 CSS、JS 文件)提前推送给浏览器,而不必等待浏览器逐个请求。
- HTTP/3(2022 年):放弃了 TCP,转而基于 QUIC 协议(运行在 UDP 之上)。QUIC 将传输层连接建立与 TLS 加密握手合并,首次连接仅需 1 个 RTT(甚至 0-RTT 重连),并在传输层实现了真正的多路复用——即使某个流的数据包丢失,也不会阻塞其他流的传输。目前主流浏览器和许多大型网站均已支持 HTTP/3。
4.3.3 Cookies与Web隐私
HTTP 无状态并不意味着服务器不能识别用户。服务器可在响应中设置 Cookie,客户端保存该标识并在后续请求中自动携带。服务器根据 Cookie 恢复用户会话状态,从而记录购物车、登录状态等信息。Cookie 同时可能被第三方用于跨站跟踪,带来隐私风险。
4.3.4 Web 缓存与代理
为了加速访问,因特网使用了 Web 缓存(也叫代理服务器)。当校园网内的多名同学都要看同一个热门视频时,学校的代理服务器会下载一份副本。这样,第一位同学之后的请求都只需从校内服务器获取,大大减少了外部带宽消耗和等待时间。
4.4 常见的网络服务
互联网中的多项应用依赖基础服务。本节介绍域名解析、电子邮件和内容分发三类常见服务。
4.4.1 域名系统
1. 为什么需要DNS
因特网中的每一台主机都通过 IP 地址来标识。然而,IP 地址(如 202.108.22.5 或 2001:db8::1)对人类来说既难以记忆,也不具有直观含义。人们更习惯使用有意义的域名(Domain Name) 来访问网站,例如 www.taobao.com 或 mail.qq.com。
域名系统(DNS, Domain Name System) 负责将便于记忆的域名解析为机器使用的 IP 地址。客户端访问某一域名时,通常首先进行 DNS 解析。
DNS 不仅仅是一个简单的"查找表",它实际上是一个层次化的分布式数据库系统,也是因特网上规模最大的分布式系统之一。全球有数千台 DNS 服务器协同工作,每天处理数万亿次查询请求。
2. 域名的层次结构
域名采用层次化命名体系,由多个标签用"."连接组成,从右到左层级依次升高。以域名 mail.cs.tsinghua.edu.cn 为例:
表4-9 域名层次结构
| 层级 | 标签 | 含义 |
|---|---|---|
| 根域 | .(通常省略) |
域名树的根节点 |
| 顶级域(TLD) | cn |
中国的国家顶级域名 |
| 二级域 | edu |
教育机构 |
| 三级域 | tsinghua |
清华大学 |
| 四级域 | cs |
计算机科学与技术系 |
| 主机名 | mail |
该系的邮件服务器 |
顶级域名(TLD)分为两大类:
- 通用顶级域名(gTLD):如
.com(商业机构)、.org(非营利组织)、.net(网络服务)、.edu(教育机构)、.gov(政府部门)等。近年来还新增了大量新通用顶级域名,如.shop、.app、.cloud等。 - 国家和地区顶级域名(ccTLD):如
.cn(中国)、.us(美国)、.jp(日本)、.uk(英国)等。
3. DNS服务器的层次体系
DNS 的权威解析体系由根服务器、顶级域名服务器和权威服务器三级组成,实际查询过程中还使用本地递归解析器:
1. 根 DNS 服务器(Root DNS Server)
根服务器位于 DNS 层次结构的最顶端。全球共有 13 组根服务器(标识为 A 到 M),由不同的组织运营。每组根服务器实际上通过任播(Anycast) 技术部署了数百台物理服务器分布在全球各地,总数超过 1500 台。根服务器并不直接存储所有域名的记录,而是负责指引查询者找到对应的顶级域名服务器。
2. 顶级域名(TLD)DNS 服务器
负责管理在该顶级域下注册的所有域名。例如,.com 的 TLD 服务器知道所有 xxx.com 域名对应的权威 DNS 服务器地址;.cn 的 TLD 服务器知道所有 xxx.cn 域名的信息。TLD 服务器由域名注册管理机构运营,如 Verisign 运营 .com 和 .net,中国互联网络信息中心(CNNIC)运营 .cn。
3. 权威 DNS 服务器(Authoritative DNS Server)
存储着特定域名的最终记录。每个拥有公开可访问主机的组织都必须提供权威 DNS 服务器(或委托给 DNS 服务商托管)。例如,清华大学的权威 DNS 服务器存储着 tsinghua.edu.cn 下所有主机名对应的 IP 地址。
4. 本地 DNS 服务器(Local DNS Server)
也称递归解析器(Recursive Resolver)。它不属于 DNS 的权威层级体系,但是用户最先接触的 DNS 服务器。客户端发起 DNS 查询时,请求首先发送到本地 DNS 服务器。该服务器通常由 ISP、学校或企业网络提供,也可以配置为公共 DNS 服务。本地 DNS 服务器代替客户端完成查询,并返回最终结果。
4. DNS查询过程
假设同学在校园网内的电脑上访问 www.taobao.com,完整的 DNS 解析过程如下:
- 检查本机缓存:浏览器首先查看自身的 DNS 缓存,如果之前不久刚访问过该域名,缓存中可能还有记录,直接使用即可。如果没有,则查询操作系统的 DNS 缓存。
- 向本地 DNS 服务器发起查询:本机缓存未命中时,操作系统将查询请求发送给预配置的本地 DNS 服务器(如学校网络中心的 DNS
10.0.0.1)。 - 本地 DNS 服务器检查自身缓存:如果该服务器近期已解析过
www.taobao.com,直接返回缓存的结果。否则,开始向上级服务器逐级查询。 - 查询根服务器:本地 DNS 服务器向根服务器发送查询请求。根服务器不知道
www.taobao.com的 IP 地址,但知道负责.com的 TLD 服务器地址,于是将其返回。 - 查询 TLD 服务器:本地 DNS 服务器再向
.com的 TLD 服务器发送查询。TLD 服务器知道taobao.com的权威 DNS 服务器地址,将其返回。 - 查询权威服务器:本地 DNS 服务器最后向
taobao.com的权威 DNS 服务器发送查询,获得www.taobao.com对应的 IP 地址(如140.205.220.96)。 - 返回结果并缓存:本地 DNS 服务器将结果返回给用户的电脑,并将该记录存入缓存(附带一个生存时间 TTL,指定缓存有效期,到期后需重新查询)。浏览器随后用这个 IP 地址与目标服务器建立连接。
上述过程中,本地 DNS 服务器扮演的是递归查询(Recursive Query)的角色——它代替用户一路追查到底并返回最终答案。而本地 DNS 服务器与根服务器、TLD 服务器、权威服务器之间的交互则通常采用迭代查询(Iterative Query),每台服务器不代为追查,只告诉查询者"你应该去问谁",由查询者自己逐步询问。
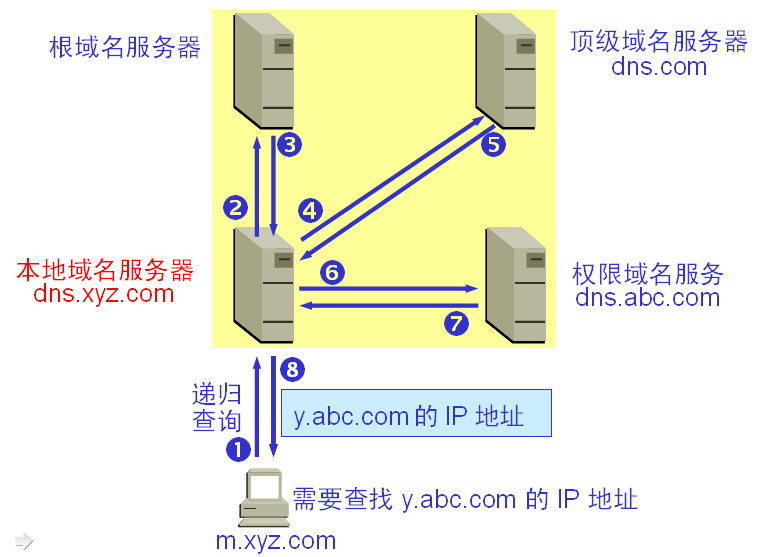
图4-5 DNS 域名解析的基本过程
5. DNS资源记录
DNS 数据库中存储的每一条信息称为一条资源记录(Resource Record, RR)。每条记录是一个四元组 (Name, Value, Type, TTL),其中 TTL 是该记录的缓存有效时间。常见的记录类型如下:
表4-10 常见 DNS 资源记录类型
| 记录类型 | 名称 | 含义 | 示例 |
|---|---|---|---|
| A | 地址记录 | 将域名映射为 IPv4 地址 | www.example.com → 93.184.216.34 |
| AAAA | IPv6 地址记录 | 将域名映射为 IPv6 地址 | www.example.com → 2606:2800:220:1:... |
| CNAME | 规范名记录 | 将域名别名指向另一个域名 | blog.example.com → example.github.io |
| MX | 邮件交换记录 | 指定接收该域邮件的邮件服务器 | example.com → mail.example.com(优先级 10) |
| NS | 名称服务器记录 | 指定负责该域的权威 DNS 服务器 | example.com → ns1.example.com |
| TXT | 文本记录 | 存储任意文本信息,常用于域名验证和反垃圾邮件 | example.com → "v=spf1 include:..." |
例如,向 student@pku.edu.cn 发送邮件时,发件方邮件服务器会查询 pku.edu.cn 的 MX 记录,以确定接收邮件的服务器地址。
6. DNS 缓存与性能优化
DNS 缓存机制能够显著提高解析效率。从本机浏览器到操作系统,从本地 DNS 服务器到各级上游服务器,每一级都会缓存最近查询过的记录。多数 DNS 查询可在本地缓存中命中,无需逐级查询到根服务器,解析时间通常为毫秒级。
需要注意的是,缓存也带来一个潜在问题:如果某个域名的 IP 地址发生变更(例如网站迁移到新的服务器),旧的缓存记录在 TTL 到期之前仍然会被使用,导致用户在一段时间内访问到旧地址。因此,网站运维人员在计划迁移时,通常会提前将 DNS 记录的 TTL 缩短,以加速记录的全网更新。
4.4.2 电子邮件系统
电子邮件是因特网最早也是最重要的应用之一。尽管如今即时通信工具非常普及,电子邮件在商务沟通、学术交流、官方通知等正式场景中仍然不可替代。
1. 电子邮件系统的组成
一个完整的电子邮件系统由三个核心组件构成:
1. 用户代理(User Agent, UA)
也称邮件客户端,是用户读写邮件的应用程序。常见的用户代理包括 Microsoft Outlook、Apple Mail、Mozilla Thunderbird 等桌面客户端,以及网页版邮箱(如 QQ 邮箱、Gmail 的 Web 界面,本质上是运行在浏览器中的用户代理)。用户代理负责撰写新邮件、展示收到的邮件、管理邮件文件夹等面向用户的操作。
2. 邮件服务器(Mail Server)
邮件服务器是邮件系统的核心枢纽。每个用户都在某台邮件服务器上拥有一个邮箱(Mailbox),用于存储收到的邮件。邮件服务器既充当"发件方"——将用户发出的邮件投递给目标服务器;也充当"收件方"——接收来自其他服务器的邮件并存入对应用户的邮箱。每台邮件服务器还维护一个外出邮件队列,存放等待发送的邮件。如果投递失败(例如目标服务器暂时不可达),服务器会在队列中保留该邮件,隔一段时间重试,通常在持续失败后才会通知发件人投递失败。
3. 邮件传输协议
邮件在不同组件之间的传递依赖于专门的应用层协议,主要包括 SMTP(用于发送和中转邮件)和 IMAP/POP3(用于用户读取邮件),下文将分别介绍。
2. 邮件发送过程详解
假设同学 Alice(alice@163.com)发一封邮件给同学 Bob(bob@qq.com),完整过程如下:
- 撰写邮件:Alice 在自己的邮件客户端中撰写邮件,填写收件人地址
bob@qq.com、主题和正文,然后点击"发送"。 - 提交到发件服务器:Alice 的邮件客户端通过 SMTP 协议将邮件提交给 163 邮箱的邮件服务器(如
smtp.163.com)。 - DNS 查询 MX 记录:163 的邮件服务器从收件地址中提取域名
qq.com,向 DNS 查询该域的 MX 记录,获得 QQ 邮箱的邮件服务器地址(如mx1.qq.com)。 - 服务器间 SMTP 传输:163 的邮件服务器与
mx1.qq.com建立 TCP 连接(目标端口 25),通过 SMTP 协议将邮件传送过去。 - 存入收件邮箱:QQ 邮箱的邮件服务器收到邮件后,将其存放到 Bob 的邮箱中。
- Bob 读取邮件:Bob 打开手机上的 QQ 邮箱客户端,客户端通过 IMAP 协议连接到 QQ 邮箱服务器,拉取新邮件,Bob 看到 Alice 发来的邮件。
可以看出,整个过程中 SMTP 负责"推送"邮件(从发件人到发件服务器,以及从发件服务器到收件服务器),而 IMAP 负责"拉取"邮件(从收件服务器到收件人的客户端)。
3. SMTP协议
SMTP(Simple Mail Transfer Protocol,简单邮件传输协议) 是电子邮件发送和中转的核心协议。SMTP 使用 TCP 作为传输协议,默认端口号为 25(服务器间中转)或 587(用户客户端提交邮件时推荐使用的端口)。
4. 邮件报文格式与MIME
电子邮件的报文分为首部(Header) 和主体(Body) 两部分。首部包含若干键值对形式的字段,常见的有:
表4-11 常见邮件首部字段
| 字段 | 含义 | 示例 |
|---|---|---|
From |
发件人地址 | From: alice@163.com |
To |
收件人地址 | To: bob@qq.com |
Subject |
邮件主题 | Subject: Meeting Tomorrow |
Date |
发送日期和时间 | Date: Wed, 12 Mar 2025 10:30:00 +0800 |
Cc |
抄送地址 | Cc: carol@example.com |
由于 SMTP 只支持 7 位 ASCII 文本,为了能够发送中文、图片、音频、附件等多媒体内容,引入了 MIME(多用途因特网邮件扩展,Multipurpose Internet Mail Extensions) 标准。MIME 通过在邮件首部中添加额外字段来描述邮件主体的编码方式和内容类型:
Content-Type:声明邮件内容的类型,如text/plain(纯文本)、text/html(HTML 格式)、image/jpeg(JPEG 图片)、multipart/mixed(包含附件的混合类型邮件)等。Content-Transfer-Encoding:声明编码方式,如base64(将二进制数据编码为 ASCII 字符串)或quoted-printable(对非 ASCII 字符进行编码,保留大部分可读文本)。
通过 MIME,一封邮件可以包含格式丰富的 HTML 正文、内嵌图片以及多个不同类型的附件。
5. 邮件读取协议
用户从邮件服务器读取邮件时,使用的不是 SMTP,而是专门的邮件访问协议。目前主流的有两种:
IMAP(Internet Mail Access Protocol,因特网邮件访问协议)
IMAP默认端口号为 143(加密连接使用 993)。IMAP 的核心设计思想是邮件保留在服务器上,客户端可以远程操作服务器上的邮箱。
IMAP 的主要特性包括:
- 多设备同步:由于邮件存储在服务器端,用户在手机上阅读了一封邮件并标记为已读后,在电脑上打开邮箱时也能看到同样的已读状态。反之,在电脑上删除一封邮件后,手机端也会同步删除。
- 文件夹管理:用户可以在服务器上创建、重命名、删除邮件文件夹(如"工作"、"学习"、"已归档"等),并在不同文件夹之间移动邮件。
- 按需下载:IMAP 允许客户端只下载邮件的首部信息(发件人、主题、日期等),用户决定阅读某封邮件时才下载完整正文和附件,节省了移动网络下的流量。
POP3(Post Office Protocol version 3,邮局协议第 3 版)
POP3默认端口号为 110(加密连接使用 995)。与 IMAP 不同,POP3 的设计理念是将邮件下载到本地。
POP3 有两种工作模式:
- 下载并删除模式:客户端从服务器下载邮件后,服务器上的副本被删除。这意味着邮件只存在于下载时使用的那台设备上,无法在其他设备上再次访问。
- 下载并保留模式:邮件下载后仍保留在服务器上,但 POP3 不支持对服务器上的邮件进行状态同步和文件夹管理。
4.4.3 内容分发网络(CDN)
即使视频经过了高效压缩,当一个热门视频同时被数千万用户观看时,如果所有请求都涌向同一台源服务器,该服务器的带宽和处理能力将不堪重负。CDN(Content Delivery Network / Content Distribution Network,内容分发网络) 正是为解决这一问题而设计的大规模分布式系统。
CDN 的核心思想: 将内容的副本提前分发到部署在全球(或全国)各地的边缘服务器(Edge Server) 上,当用户请求内容时,CDN 将用户引导至距离最近或负载最优的边缘服务器,从就近节点提供服务,而非从远在千里之外的源站获取。
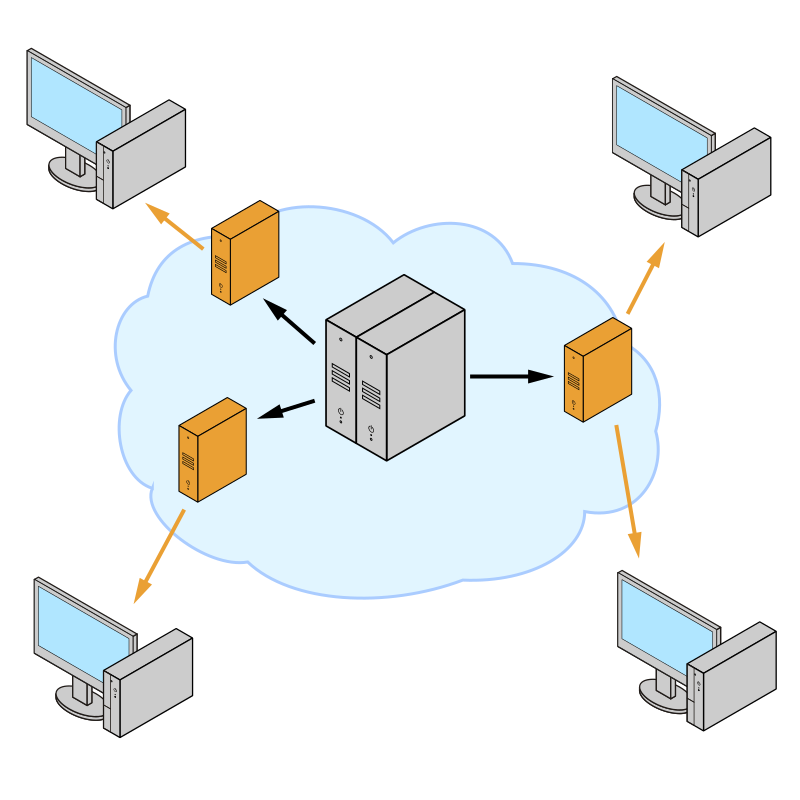
图4-6 内容分发网络(CDN)的基本结构
CDN 的部署策略有两种典型方式:
- 深入策略(Enter Deep):将 CDN 服务器部署到各地 ISP 的接入网内部(如运营商的机房中),使服务器尽可能靠近终端用户。这种方式用户体验最好(延迟最低),但部署和维护成本极高,需要与大量 ISP 合作。
- 邀请做客策略(Bring Home):在关键位置(如大城市的 IXP、骨干网节点)集中部署少量大型数据中心。每个数据中心服务周边较大区域的用户。部署和维护成本较低,但用户到服务器的距离相对较远。
CDN 的工作流程: 以用户观看某视频网站的视频为例:
- 用户点击视频链接,浏览器向视频网站的服务器请求视频页面。
- 视频页面中的视频 URL 指向 CDN 的域名(如
video.cdn-provider.com)。 - 浏览器对该 CDN 域名进行 DNS 解析。CDN 提供商的智能 DNS 系统会根据用户的地理位置、各节点的负载状况和网络拓扑,将域名解析为距离用户最优的边缘服务器的 IP 地址。
- 浏览器向该边缘服务器发起 HTTP 请求。
- 如果该边缘服务器已经缓存了所请求的视频片段,直接返回给用户(缓存命中)。
- 如果未缓存,边缘服务器首先从源站(或上一级 CDN 节点)拉取视频片段,缓存到本地后再返回给用户。后续其他用户请求同一视频片段时,可直接从缓存中获取。
CDN 的核心价值在于:
- 降低延迟:用户从地理位置较近的节点获取内容,网络传输距离大幅缩短。
- 减轻源站压力:海量的用户请求被分散到各边缘节点,源站只需处理少量缓存未命中的回源请求。
- 提高可用性:即使某个节点出现故障,用户请求可以被自动调度到其他健康的节点。
CDN 不仅服务于视频流媒体,在网页加速、软件分发、在线游戏更新包下载、电子商务大促(如"双 11")等场景中都发挥着关键作用。在物流行业中,物流企业的全国性运单查询系统、实时物流追踪地图等面向公众的服务,同样依赖 CDN 来应对全国范围的高并发访问。
4.5 网络安全基础
互联网的开放性和异构性使数据传输面临截获、篡改和伪造等风险。网络安全的目标是在开放网络环境中保证信息机密性、完整性、可用性和真实性。
4.5.1 安全威胁
互联网面临的主要威胁可分为被动攻击和主动攻击。被动攻击通过窃听或流量分析获取通信内容,主要破坏信息机密性;主动攻击通过篡改报文、伪造身份、拒绝服务等方式破坏数据完整性、可用性和实体真实性。
网络安全的基本目标包括机密性、完整性、可用性、身份认证、不可否认性和访问控制。机密性保证数据仅对授权实体可见;完整性保证数据在传输和存储过程中未被非法修改;可用性保证授权用户能够正常访问资源;身份认证用于确认通信实体身份;不可否认性防止通信一方事后否认已发生的行为;访问控制限制用户对资源的操作权限。
4.5.2 密码学基础
密码学(Cryptography) 是网络安全的数学基石。其核心思想是:将可读的明文(Plaintext)通过某种算法和密钥(Key)变换为不可读的密文(Ciphertext),只有持有正确密钥的接收方才能将密文还原为明文。这一过程可以形式化表示为:
其中
根据加密和解密所使用的密钥是否相同,密码体制分为两大类:对称加密和非对称加密(公钥加密)。
1. 对称加密
对称加密的特征是:加密和解密使用同一把密钥(即
为便于理解加密原理,先看一个最简单的替换密码。假设密钥规则为"每个字母向后移动 3 位"(即凯撒密码)。明文为 "HELLO",将每个字母向后移动 3 位后,得到密文 "KHOOR":H→K,E→H,L→O,L→O,O→R。收到密文 "KHOOR" 后,接收方只需将每个字母向前移动 3 位即可恢复明文 "HELLO"。当然,这种简单替换极易被频率分析破解(英文中 E 出现频率最高,据此可推断移位量),因此实际应用中使用的是远比它复杂的算法。
现代对称加密算法:
- DES(Data Encryption Standard):1977 年发布的早期标准,使用 56 位密钥对 64 位数据块进行加密。由于密钥长度过短(
种可能的密钥已可在数小时内被穷举破解),DES 目前已不再安全。 - 3DES(Triple DES):对数据依次执行三轮 DES 运算(加密→解密→加密),使用两个或三个独立密钥,有效密钥长度提升至 112 或 168 位,安全性大幅增强,但运算速度较慢。
- AES(Advanced Encryption Standard):2001 年取代 DES 成为新标准,支持 128 位、192 位和 256 位三种密钥长度。AES 基于替代-置换网络(SPN) 结构,将明文分为 128 位的数据块,经过多轮(10/12/14 轮)的字节替换、行移位、列混合和密钥加操作,生成密文。AES 目前被认为是最安全的对称加密算法之一,广泛应用于 WiFi 加密(WPA2/WPA3)、VPN、磁盘加密、HTTPS 数据传输等场景。
对称加密最大的优势在于运算速度极快,非常适合加密大批量数据,例如加密1GB 文件,AES在现代 CPU 上通常只需不到 1 秒。然而,它也存在明显的局限,即密钥分发问题,通信双方必须通过安全渠道预先共享密钥,若一方需要与多个对象分别通信,就需维护多把不同密钥,而在互联网等开放环境中,安全分发密钥往往较为困难。
2. 非对称加密
为了解决对称加密的密钥分发难题,1976 年 Diffie 和 Hellman 提出了公钥密码体制的革命性思想,随后 Rivest、Shamir 和 Adleman 在 1978 年给出了第一个实用的公钥算法——RSA。
公钥加密的核心特征是:每个用户拥有一对数学上相关但不同的密钥,其中**公钥(Public Key)可以公开发布,任何人都能获取;而私钥(Private Key)**则必须严格保密,仅由本人持有。这对密钥具有以下性质:用公钥加密的数据只能用对应的私钥解密,反之亦然——用私钥加密的数据只能用对应的公钥解密。数学上,基于大整数分解或离散对数等数学难题,从公钥推导出私钥在计算上是不可行的。
假设用户 A 要向用户 B 发送一份保密数据,过程如下:
- Bob 事先生成自己的公钥
和私钥 ,并将公钥 公开发布(例如挂在个人主页上)。 - A 获取 B 的公钥
,并用其加密数据: 。 - A 将密文
通过互联网发送给 B。即使攻击者截获密文 和公钥 ,由于没有 B 的私钥,也无法解密。 - B 用自己的私钥
解密: 。
整个过程中,双方从未交换过任何秘密信息,Alice 只需要 Bob 的公钥(公开的),Bob 只需要自己的私钥(从未离开过自己的设备)。这彻底解决了密钥分发问题。
RSA 的安全性建立在大整数质因数分解的困难性之上。其密钥生成过程可简述为:
- 选取两个大素数
和 (各自通常为 1024 位以上),计算乘积 。 - 计算欧拉函数
。 - 选取一个与
互素的整数 (常取 65537),作为公钥指数。 - 计算
关于 的模逆元 ,使得 , 作为私钥指数。
公钥为
非对称加密的最大优势在于无需安全信道传递密钥,因而特别适合开放的互联网环境;但其代价是运算速度比对称加密慢约 100~1000 倍,因此并不适合直接用于加密大量数据。
3. 混合加密
实际的安全通信系统(如 HTTPS、VPN)通常采用混合加密策略,结合两者的优势:
- 发送方随机生成一个一次性的对称密钥(称为会话密钥,Session Key),例如一个 256 位的 AES 密钥。
- 用接收方的公钥加密该会话密钥,将密文发给接收方。
- 接收方用自己的私钥解密,得到会话密钥。
- 此后双方用该会话密钥进行对称加密通信,传输大量数据,。
HTTPS 即采用这种混合加密方式:公钥加密用于握手阶段交换会话密钥,对称加密用于此后传输大量数据。
4. 报文摘要与散列函数
除了加密,网络安全还需要一种机制来验证数据在传输过程中是否被篡改。密码散列函数(Cryptographic Hash Function) 正是为此而设计的。
散列函数
- 确定性:相同的输入必定产生相同的输出。
- 雪崩效应:输入发生哪怕 1 比特的改变,输出的散列值也会发生巨大变化。
- 单向性:从散列值无法反推出原始数据。
- 抗碰撞性:在计算上不可能找到两个不同的输入产生相同的散列值。
常用的散列算法包括 SHA-256(输出 256 位摘要)和 SHA-3。下载软件安装包时,发布方通常会提供文件的 SHA-256 散列值。用户下载完成后可重新计算散列值并与发布值比较。两者一致说明文件未被篡改或损坏;不一致则说明文件可能已被修改或下载不完整。
4.5.3 数字签名与认证中心 (CA)
1. 数字签名的原理
在物理世界中,手写签名用于证明文件的签署者身份并表示签署者对文件内容的认可。在数字世界中,数字签名(Digital Signature) 实现了同样的功能,但依赖的是数学而非墨水。
数字签名利用了公钥密码体制的一个对称性——用私钥"加密"的数据可以用公钥"解密"。由于私钥只有签名者本人持有,因此能够用签名者的公钥成功验证的签名,必定出自签名者之手。
完整的数字签名过程如下:
签名阶段
- Alice 对原始文件
计算散列摘要: 。 - Alice 用自己的私钥
对摘要进行加密(签名): 。 - Alice 用 Bob 的公钥
对原始文件 和数字签名 进行加密: 。 - Alice 将密文
发送给 Bob。
验证阶段
- Bob 用自己的私钥
解密密文,得到原始文件 和数字签名 : 。 - Bob 用 Alice 的公钥
解密签名,得到摘要值: 。 - Bob 对收到的文件
独立计算散列摘要: 。 - 比较
和 : - 若
,说明文件确实由 Alice 签署(身份认证),且内容在传输过程中未被篡改(完整性)。 - 若
,说明文件可能被篡改或签名无效,应当拒绝。
- 若
数字签名通常对散列摘要而不是原文执行,原因是公钥加密运算速度较慢。若直接对大型文件进行 RSA 签名,耗时较长;散列运算可将任意长度文件压缩为固定长度摘要,再对摘要签名可显著降低计算开销。
图4-7 非对称加密与数字签名流程
数字签名提供了三项安全保障。一是身份认证,即确认消息确实来自声称的发送者,其实现依赖于只有持有私钥的人才能生成有效签名这一特性;二是数据完整性,即确认消息内容未被篡改,因为散列值对原文的任何修改都极度敏感,哪怕原文只发生一个字符的变化,散列值也会截然不同;三是不可否认性,即发送者事后不能否认自己发送过此消息,这是因为私钥仅本人持有,签名无法被他人伪造。
2. 认证中心与数字证书
公钥加密和数字签名的安全性都建立在一个前提上:Bob 获取的确实是 Alice 的真正公钥。如果攻击者 Eve 伪造了一把公钥,声称它属于 Alice,并设法让 Bob 接受,那么 Eve 就可以冒充 Alice 与 Bob 通信——这就是中间人攻击(Man-in-the-Middle Attack)。
为了解决"公钥的可信分发"问题,需要引入一个受所有人信任的第三方——认证中心(CA, Certificate Authority)。
CA 的工作机制如下:
- 申请证书:Alice 向 CA 提交自己的身份信息(如姓名、域名)和公钥
,请求签发数字证书。 - 身份核验:CA 通过各种手段(查验营业执照、域名所有权验证等)确认 Alice 的身份真实性。
- 签发证书:CA 将 Alice 的身份信息和公钥打包,并用 CA 自己的私钥
对这个包进行数字签名,生成 数字证书(Digital Certificate)。
数字证书的核心结构(遵循 X.509 标准)包含以下关键字段:
表4-12 X.509 数字证书的主要字段
| 字段 | 内容 |
|---|---|
| 主体(Subject) | 证书持有者的身份信息(如 CN=www.example.com) |
| 公钥(Public Key) | 持有者的公钥 |
| 签发者(Issuer) | 签发此证书的 CA 名称 |
| 有效期(Validity) | 证书的生效日期和过期日期 |
| 序列号(Serial Number) | CA 分配的唯一编号 |
| CA 的数字签名 | CA 用自己的私钥对以上所有字段计算的签名值 |
验证证书的过程: 当 Bob 收到 Alice 的数字证书时,他用 CA 的公钥
证书验证过程: 浏览器访问银行网站 https://www.icbc.com.cn 时:
- 服务器将自己的数字证书发送给浏览器。
- 浏览器检查证书的签发 CA(如 DigiCert)是否在自己信任的根 CA 列表中。
- 浏览器用该 CA 的公钥验证证书上的数字签名。
- 验证通过后,浏览器确认该公钥确实属于
www.icbc.com.cn,地址栏显示小锁图标。 - 如果证书已过期、域名不匹配或签名无效,浏览器会弹出安全警告,提醒用户该网站可能不安全。
3. 证书信任链
实际中 CA 存在层级结构:
- 根 CA(Root CA):位于信任链的顶端,其根证书预装在操作系统和浏览器中(如 Windows 系统预装了数百个受信任的根证书)。根 CA 的证书是自签名的——即用自己的私钥签署自己的证书。
- 中间 CA(Intermediate CA):由根 CA 签发证书并授权,负责向终端用户签发证书。引入中间 CA 层可以使根 CA 的私钥保持离线存储,降低泄露风险。
验证一个证书时,浏览器会沿着证书链逐级向上验证签名:终端证书 → 中间 CA 证书 → 根 CA 证书。只要链条上的每一环签名都有效,且根 CA 受浏览器信任,整个证书就被视为可信。
4.5.4 HTTPS
HTTPS(Hypertext Transfer Protocol Secure)在 HTTP 和 TCP 之间增加 SSL/TLS 安全层,默认使用 443 端口。客户端与服务器通过 TLS 握手完成身份认证和参数协商:客户端验证服务器数字证书,双方通过密钥交换算法生成会话密钥,此后使用对称加密保护 HTTP 报文。HTTPS 能够防止传输数据被窃听和篡改,并验证服务器身份。
4.5.5 网络安全实务
前面介绍了密码学、数字签名和 HTTPS 等安全原理。下面讨论网络边界防护、远程接入和常见攻击防范等实际措施。
1. 防火墙
防火墙是部署在网络边界处的安全设备,可以是专用硬件,也可以是运行在服务器上的软件,其核心职责是依据预先配置的安全策略对进出网络的数据包进行检查,决定放行或丢弃。
防火墙按照检测粒度可分为以下几类:
表4-13 防火墙分类
| 类型 | 工作层次 | 原理 | 典型应用 |
|---|---|---|---|
| 包过滤防火墙 | 网络层 | 检查数据包首部的源/目的 IP 地址、端口号等字段,与规则表逐条匹配 | 路由器上的 ACL(访问控制列表) |
| 状态检测防火墙 | 传输层 | 在包过滤基础上记录连接状态,只允许属于已建立会话的数据包通过 | 企业网关防火墙 |
| 应用层网关(代理防火墙) | 应用层 | 对特定应用协议(HTTP、FTP 等)的内容进行深度检查 | Web 应用防火墙(WAF) |
以一家物流企业为例:IT 管理员可以在防火墙上设置规则——"只允许仓库管理系统的 IP 地址段访问订单数据库的 3306 端口",从而将不必要的外部访问挡在门外。现代企业通常还会部署入侵检测系统(IDS)和入侵防御系统(IPS),前者负责监控并报警,后者在检测到攻击时主动阻断恶意流量。
2. 虚拟专用网 (VPN)
物流企业的分支机构遍布各地,员工经常需要在仓库、港口甚至出差途中远程接入总部系统。如果直接通过公共因特网访问内部资源,数据将面临被窃听或篡改的风险。虚拟专用网(Virtual Private Network, VPN) 技术正是为解决这一问题而设计的。
VPN 的核心思想是在公共网络上构建一条逻辑上的专用隧道。首先,VPN 客户端与服务器之间需要协商建立隧道,常用的隧道协议包括 IPSec、L2TP/IPSec、OpenVPN 和 WireGuard 等;隧道建立后,进入其中的每一个数据包都会经过加密封装,即使被第三方截获也无法读取其真实内容;与此同时,系统还会通过数字证书或用户名/密码等方式进行身份认证,确保只有获得授权的用户才能接入隧道。经过上述处理,远程员工的电脑在逻辑上就像接入了公司内网一样,可以安全访问 ERP、WMS 等内部业务系统。
从应用场景看,VPN 可分为两种模式:一种是远程接入 VPN,即单个用户拨入企业网络,适用于员工远程办公的场景;另一种是站点到站点 VPN,即在两个固定网络之间建立永久隧道,适用于总部与分支机构之间的长期互联。
3. 企业内部网 (Intranet)
Intranet(企业内部网) 是在企业内部采用因特网技术栈(TCP/IP、HTTP、Web 浏览器等)构建的私有信息平台。传统的企业信息系统采用客户机/服务器(C/S)架构,每台终端都需要安装专用客户端软件,部署和维护成本高昂。Intranet 将其转变为浏览器/服务器(B/S) 架构——员工只需使用标准浏览器即可访问内部的 OA、邮件、知识库和业务管理系统,大幅降低了运维复杂度。
4. 常见网络攻击与防范
现实中频繁出现的网络攻击方式包括:
(1)钓鱼攻击(Phishing)。攻击者伪造银行、电商或政务网站的页面,通过电子邮件或短信诱骗用户点击链接并输入账号密码。防范要点是核实网址的真实性,认准 HTTPS 锁标志和正确的域名。
(2)勒索软件(Ransomware)。恶意程序加密受害者硬盘上的文件,要求支付赎金后才提供解密密钥。2017 年的 WannaCry 事件波及全球超过 150 个国家的计算机系统。防范措施包括定期备份数据、及时安装操作系统补丁以及不随意打开来历不明的附件。
(3)分布式拒绝服务攻击(DDoS)。攻击者利用大量受控设备同时向目标服务器发送海量请求,使其无法正常响应合法用户。大型电商在促销活动期间尤其需要防范此类攻击,通常借助 CDN 分流和专业的流量清洗服务来应对。
(4)中间人攻击(Man-in-the-Middle, MITM)。攻击者在通信双方之间暗中截取并可能篡改数据。HTTPS 和 VPN 正是抵御此类攻击的有效手段。
本章小结
本章围绕计算机网络的基本原理与因特网应用展开系统介绍。首先讲解了电路交换与分组交换的区别,说明了因特网采用分组交换的技术优势,并以 TCP/IP 五层模型为主线,梳理了物理层、数据链路层、网络层、传输层和应用层各自的功能与典型协议。在网络层部分,重点介绍了 IP 地址的构成、子网划分与 CIDR 表示法,以及 NAT/NAPT 技术如何缓解地址短缺问题;在传输层部分,比较了 TCP 面向连接的可靠传输与 UDP 面向无连接的高效传输,阐明了二者适用的不同场景。随后,围绕 DHCP、DNS、HTTP、电子邮件系统等因特网核心应用服务,详细说明了其工作流程与协议交互过程,并结合物流业务场景,展示了这些技术在企业信息化中的实际应用。最后,本章介绍了对称加密与非对称加密的原理,说明了 HTTPS 如何综合使用两种加密方式保障通信安全,并进一步讨论了 VPN、Intranet 等企业网络安全技术,以及钓鱼攻击、勒索软件、DDoS、中间人攻击等常见网络威胁及其防范措施。通过本章学习,读者应当掌握计算机网络的基本工作原理,理解因特网各层协议的协同关系,并能够将相关知识应用于物流企业信息系统的建设与安全防护实践中。
课后习题
-
比较电路交换和分组交换的特点,说明互联网采用分组交换的原因。
-
简述 TCP/IP 五层模型中各层的主要功能和典型协议。
-
已知某主机的 IP 地址为
192.168.10.78/27,求其网络地址、可用主机地址范围和广播地址。 -
说明 NAT 与 NAPT 的区别,以及 NAT 对端到端通信的影响。
-
简述 DHCP 客户获取 IP 地址的过程。
-
说明 HTTP 无状态特性的含义,以及 Cookie 如何在该特性下保存用户状态。
-
简述 DNS 的层次结构和递归查询、迭代查询的区别。
-
说明 SMTP、POP3 和 IMAP 在电子邮件系统中的作用。
-
比较对称加密与非对称加密的优缺点,说明 HTTPS 如何综合使用两种加密方式。
-
简述数字证书的签发和验证过程,以及证书信任链的作用。
参考文献
[1] 谢希仁. 计算机网络(第9版)[M]. 北京: 电子工业出版社, 2026.
[2] Andrew S. Tanenbaum、David J. Wetherall 著,严伟、潘爱民 译. 计算机网络(第5版)[M]. 北京: 清华大学出版社, 2012.
[3] James F. Kurose、Keith W. Ross 著. 计算机网络:自顶向下方法[M]. 北京: 机械工业出版社. 2022.
[4] Root Servers Organization. Root Servers [EB/OL]. https://root-servers.org/.